56张图,把MoE讲透了:专家选择、Token路由、Switch Transformer(附完整 PyTorch 代码)

11.gif

640.gif

“MoE” 到底代表什么?为什么现在有这么多 LLM 都在使用它呢?

——Mixture of Experts

我们知道,模型规模是提升模型性能的关键因素之一。在有限的计算资源预算下,用更少的训练步数训练一个更大的模型,往往比用更多的步数训练一个较小的模型效果更佳。

混合专家模型 (MoE) 的一个显著优势是它们能够在远少于稠密模型所需的计算资源下进行有效的预训练。

这意味着在相同的计算预算条件下,您可以显著扩大模型或数据集的规模。特别是在预训练阶段,与稠密模型相比,混合专家模型通常能够更快地达到相同的质量水平。

在本文中将用56张图片进行可视化图示,带你一步步深入了解这个关键组成部分 —— 混合专家模型(MoE,Mixture of Experts) 。

混合专家模型‌:强调多个专家(子模型)协同工作,适用于机器学习领域中通过组合不同专家处理特定任务的场景。 ‌‌

专家混合模型‌:侧重于专家(子模型)的组合方式,适用于描述神经网络架构中专家动态组合的特性。

有的地方也称为专家混合模型,都行,感觉其实差别不是特别大,我习惯叫混合专家模型。
640.webp
▲图-1

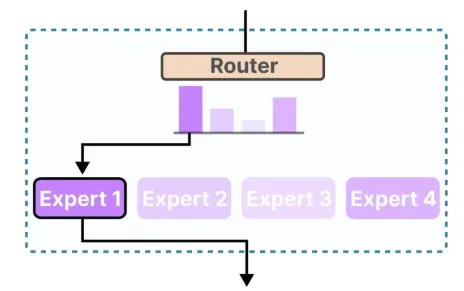
在这份图解指南中,我们将依照典型的大语言模型(LLM)架构,依次讲解 MoE 的两个核心组成部分:专家(Experts)和路由器(Router) 。
01.webp

什么是混合专家模型

专家混合模型(MoE,Mixture of Experts) 是一种提升大型语言模型(LLMs)质量的技术,它通过引入多个不同的子模型(即“专家”)来实现更好的性能。

MoE 的结构主要由两个核心组成部分构成:

  • 专家(Experts):每一层前馈神经网络(FFNN)不再是一个单一结构,而是由多个“专家”组成。每个“专家”本质上也是一个前馈神经网络。
  • 路由器(Router)或门控网络(Gate Network):负责决定每个 token(词元)应该被送到哪些专家那里去处理。

在使用 MoE 架构的大语言模型中,我们会在模型的每一层看到多个(具有一定专长的)专家:
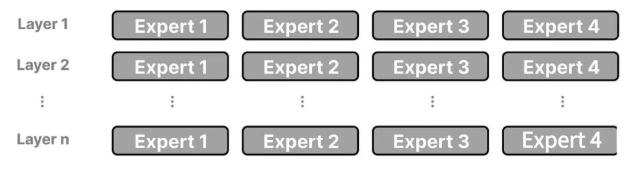
640.png
▲图-2

需要注意的是,这里的“专家”并不是指在某个具体学科领域(比如“心理学”或“生物学”)特别擅长的模型。

它们最多只是在处理某些词语的语法结构方面表现更好:
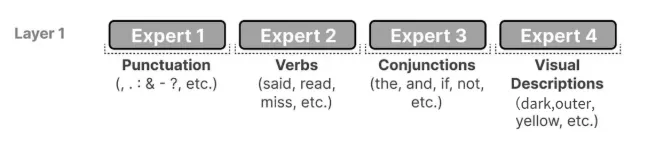
640 (1).webp
▲图-3

更准确地说,这些专家擅长处理某些特定上下文中出现的特定 token。

而路由器(或门控网络)的作用,就是根据输入内容选择最合适的专家来处理每个 token:
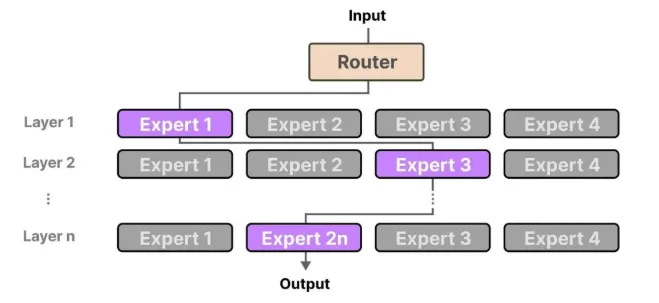
640 (2).webp
▲图-4

每个专家并不是一个完整的 LLM,而只是 LLM 架构中的一个子模块。

02.webp

专家模块

为了更好地理解“专家”代表什么,以及它们是如何工作的,我们先来看看 MoE 想要替代的是什么,稠密层(dense layers),也就是传统的“全连接层”。

稠密层

专家混合模型(MoE)的出发点,是 LLM 中最基础的组件之一:前馈神经网络(FFNN, Feedforward Neural Network) 。

回想一下,在一个标准的仅解码器(decoder-only)Transformer 架构中,FFNN 放是在层归一化(layer normalization)之后的:
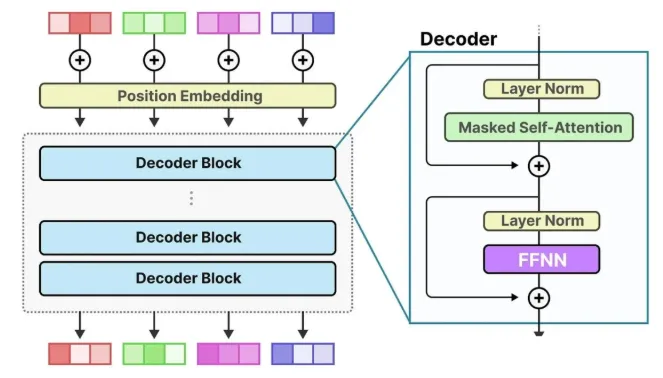
640 (3).webp
▲图-5

不了解decoer-only Transformer的人看到上面这个图可能会困惑。

  • 普通的Transformer是post-ln,结构如下:


input
 │
 ├─ Masked Multi-Head Self-Attention
 ├─ Residual Add + LayerNorm
 │
 ├─ Encoder-Decoder Cross Attention
 ├─ Residual Add + LayerNorm
 │
 ├─ Feedforward Neural Network (FFNN)
 ├─ Residual Add + LayerNorm


  • 但是decoder-only Transformer架构的模型,比如gpt系列,用的pre-ln,并且因为是decoer-only,所以不需要交叉注意力层(或者叫编码器解码器注意力层)。

因此构架是这样的:


Input
 │
 ├─ LayerNorm
 │
 ├─ Masked Multi-Head Attention
 │
 ├─ Residual Add
 │
 ├─ LayerNorm
 │
 ├─ Feedforward Neural Network (FFNN)
 │
 ├─ Residual Add


FFNN 的作用,是利用注意力机制生成的上下文信息,并进一步转换这些信息,从而捕捉数据中更复杂的关联关系。

不过,FFNN 的规模增长得非常快。为了学到这些复杂关系,它通常会对输入数据进行“扩展”:
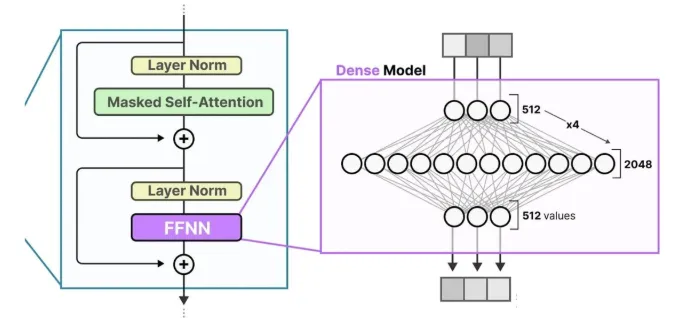
640 (4).webp
▲图-6

稀疏层

传统 Transformer 中的 FFNN 被称为稠密模型(dense model) ,因为它的所有参数(包括权重和偏置)在每次前向传播时都会被激活。所有部分都会参与运算,没有遗漏。

如果我们仔细观察一个稠密模型,会发现输入在计算中“激活”了所有的参数:
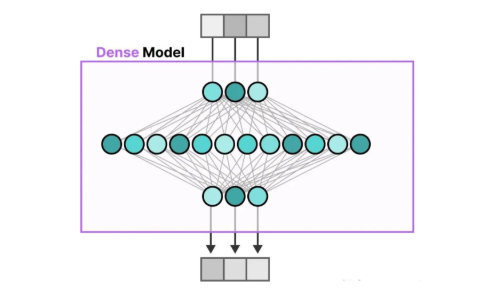
640 (1).png
▲图-7

相反,稀疏模型(sparse models) 只激活部分参数,这就与 MoE 的机制密切相关了。

举个例子:我们可以把一个密集模型拆成若干片(也就是所谓的专家),然后重新训练。

在模型实际运行时,每次只激活其中的一小部分专家:
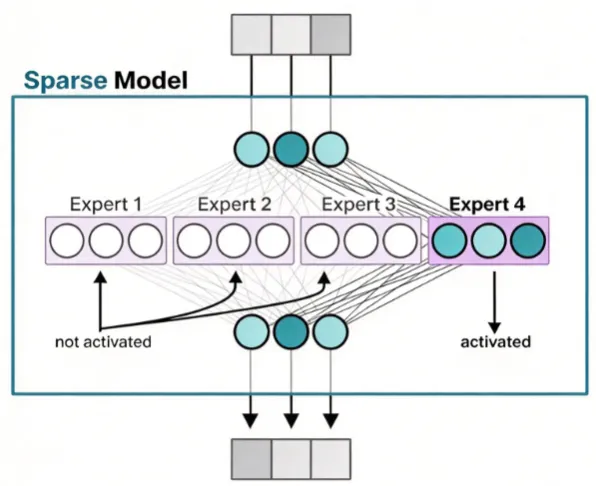
640 (5).webp
▲图-8

背后的思想是:每个专家在训练时学会了不同的知识。

因此,在推理阶段也就是模型实际使用的时候 ,只会调用那些与当前任务最相关的专家。

当我们向模型提问时,系统就会选择最适合回答这个问题的专家。
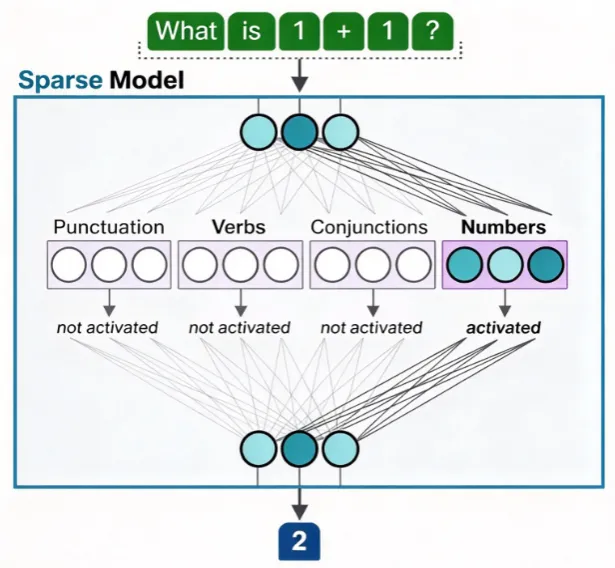
640 (6).webp
▲图-9

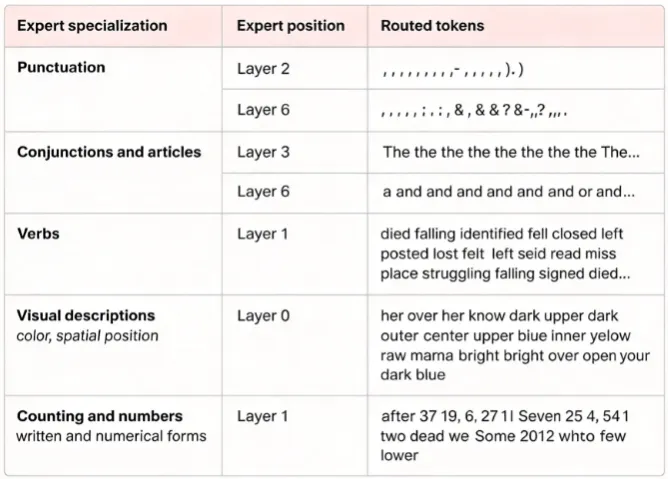
专家学到了什么?

前边我们讲到了,专家所学的信息比起整个领域而言,是更为细粒度的信息。因此,有时称它们为“专家”其实有些误导人。
640 (7).webp
▲图-10 | ST-MoE 论文,编码器模型中专家表现出的专门化。大白话就是不同专家捕获的信息。

然而,解码器模型中的专家似乎并没有表现出同样类型的专门化。当然这也并不意味着所有专家都是一样的。

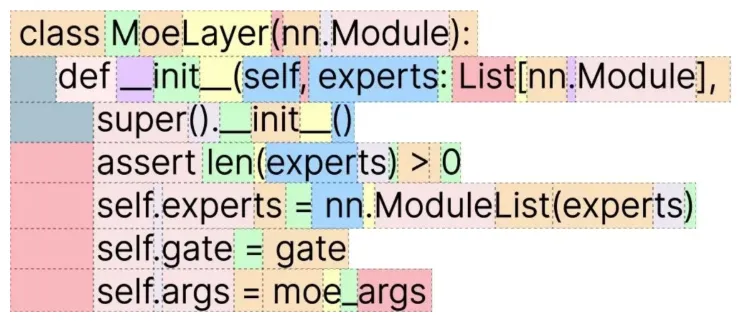
  • 举个例子,在论文 Mixtral 8x7B 中,每个token都用第一个选择它的专家进行颜色标记。

就是你一句话输入进去,不同的专家会注意到不同的token,每个专家用不同颜色表示,如果在这个句子中,某个词语第一次就被引导到某个专家,那就用这个专家的颜色进行标记。
640 (8).webp
▲图-11

这张图也显示,专家们更倾向于关注语法结构,而不是具体的领域知识。

因此,虽然解码器的专家看起来没有明显的专业领域,但它们好像会用于处理某些特定类型的token。

专家的架构

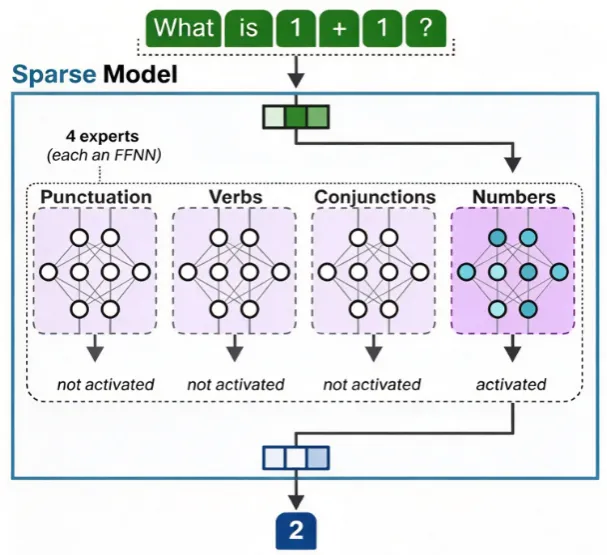
虽然我们可以把专家想象成把一个密集模型的隐藏层切分成若干部分,但实际上它们通常是完整的FFNN结构:
640 (9).webp
▲图-12

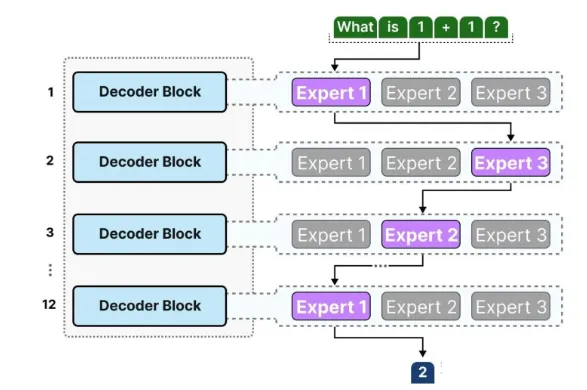
由于大多数大型语言模型有多个解码器块,一段文本在生成过程中会经过多个专家的处理:
640 (10).webp
▲图-13

不同的 token 会选择不同的专家,这就导致模型在计算时会走不同的“路径”:
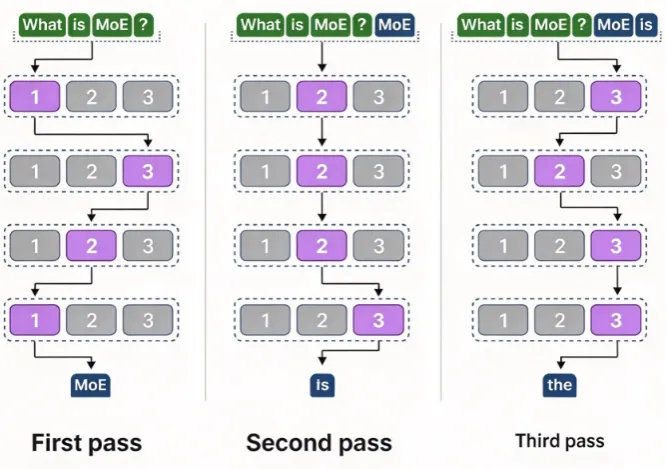
640 (11).webp
▲图-14

如果我们更新对解码器块的可视化表示,它现在会包含更多的 FFNN(每个对应一个专家):
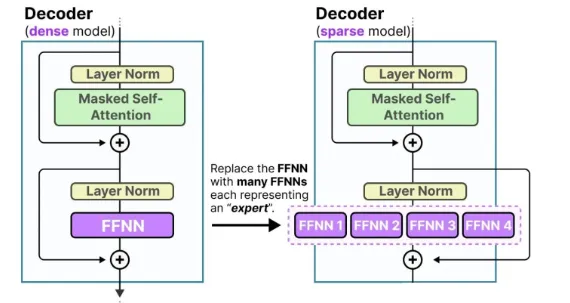
640 (12).webp
▲图-15

因此,解码器块在推理时可以根据需要使用多个 FFNN(即不同的专家)。

03.webp

路由机制

现在我们已经有了一组专家,那模型是怎么知道该使用哪些专家的呢?

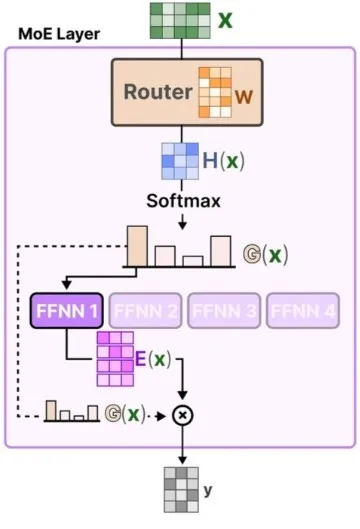
在专家模块之前,会加入一个路由器(router)(也称为门控网络 gate network),它是专门训练用于决定每个 token 应该交给哪一个专家来处理的。

路由器

路由器本身也是一个前馈神经网络(FFNN),它的作用是:根据每个 token 的输入内容,输出一组概率值,并据此选择最匹配的专家。
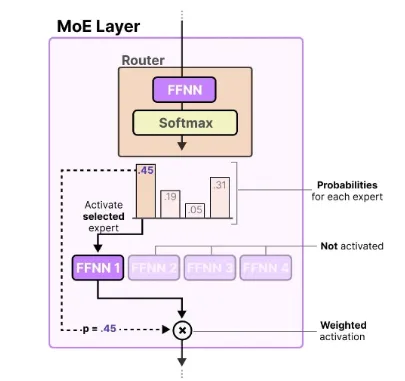
640 (13).webp
▲图-16

每个专家的输出会乘以对应的“门控值”(也就是刚才输出的概率),最终汇总后作为该层的输出。

路由器 + 一组专家(FFNN被选中的一小部分)= 构成了一个 MoE 层(MoE Layer) :
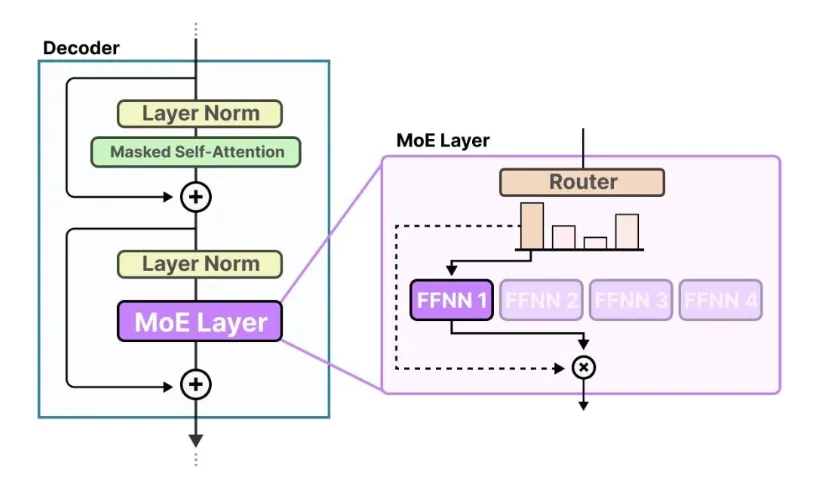
640 (14).webp
▲图-17

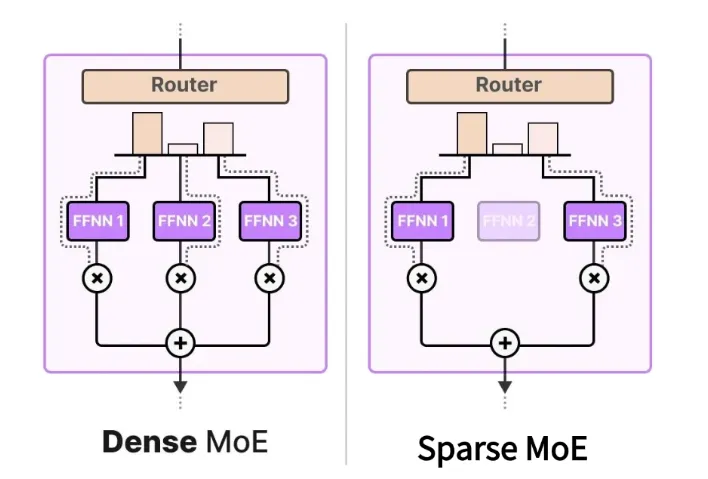
一个 MoE 层通常有两种大小类型:稀疏MoE或者稠密MoE。

两者都使用路由器来选择专家,但稀疏 MoE 每次只选择少量专家参与计算,而稠密 MoE所有专家都会参与计算,但参与程度可能不同。
640 (15).webp
▲图-18
  • 例如:对一组 token,Dense MoE 会将每个 token 分发给所有专家,而 Sparse MoE 只会分发给其中少数几个。

目前大多数 LLM 的 MoE 实现中,几乎都是稀疏MoE,因为它能有效降低推理成本,非常适合大模型。

专家选择的过程

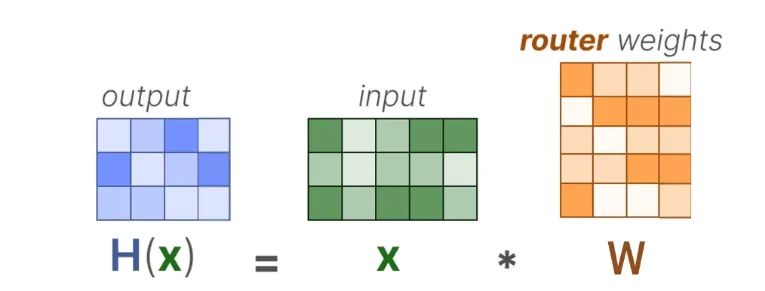
路由器其实是 MoE 中最核心的组件之一。它不仅决定推理阶段该选哪些专家,也决定训练阶段哪些专家要被更新。

最基础的做法是,将输入 token 表示向量 x ,乘以一个路由权重矩阵 W :
640 (16).webp
▲图-19

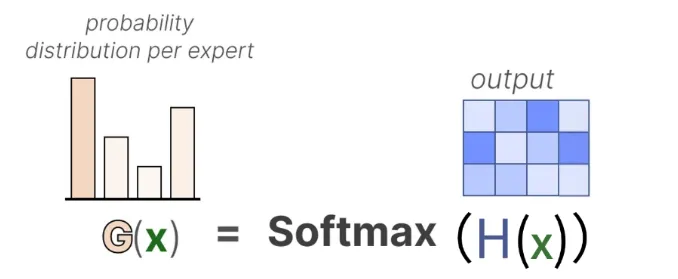
对打分结果做 SoftMax,得到一个不同专家的概率分布 G ( x ) :
640 (17).webp
▲图-20 

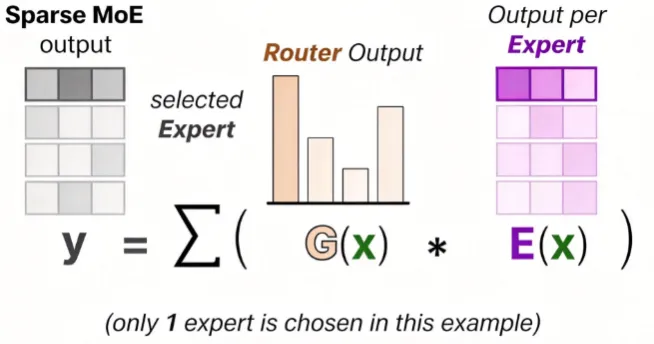
然后根据这些概率值,选出和输入最相关的专家。

最后把每个路由器的输出与对应的专家相乘,加权求和,得到该 token 的最终输出:
640 (18).webp
▲图-21

我们把所有步骤汇总起来,这就完成了一个 token 从路由器流向专家的完整过程:
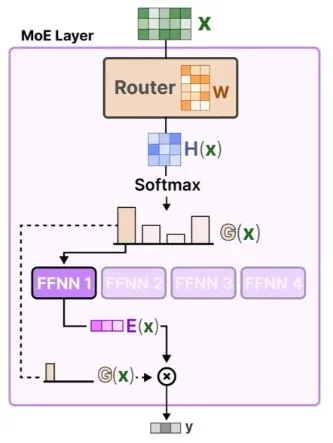
640 (54).webp
▲图-22


640 (20).webp
▲图-23

路由的挑战

不过,虽然这个机制看起来很简单,但实际上会出现一个问题,某些专家学得更快,导致路由器总是选它们。
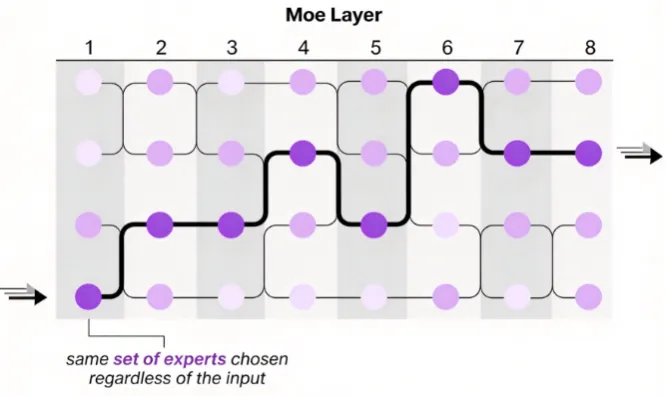
640 (21).webp
▲图-24

这样一来会导致一些问题:选择的专家不均匀,一些专家几乎不会被训练到,最终训练和推理时都容易出现偏倚和性能下降 的问题。

为了解决这个问题,引入了负载均衡(load balancing) 。

它的目的是让每个专家在训练和推理中都能被公平地使用,避免某在某几个专家上过拟合。
04.webp

负载均衡

为了让不同专家的使用更加平衡,我们需要关注的是路由器(Router) ,因为它决定了每一次选用哪些专家。

KeepTopK 策略

一种常见的路由负载均衡方法是通过一个叫做KeepTopK的简单的扩展,引入可训练的高斯噪声,以防止模型总是选中同一批专家:
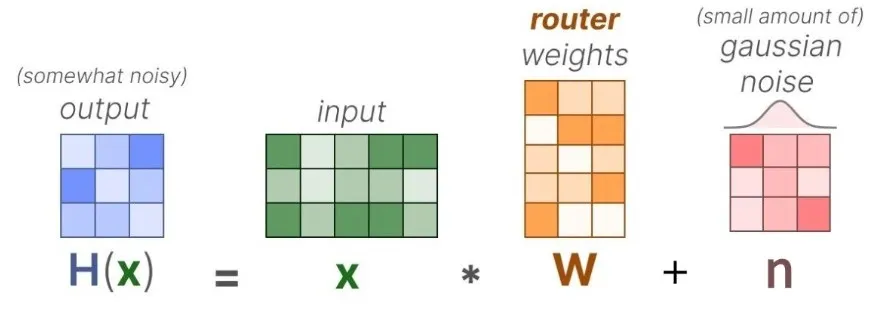
640 (22).webp
▲图-25

接下来,除了你想要激活的 Top-k 个专家(比如前 2 个),其他专家的分数全部设为 -∞:
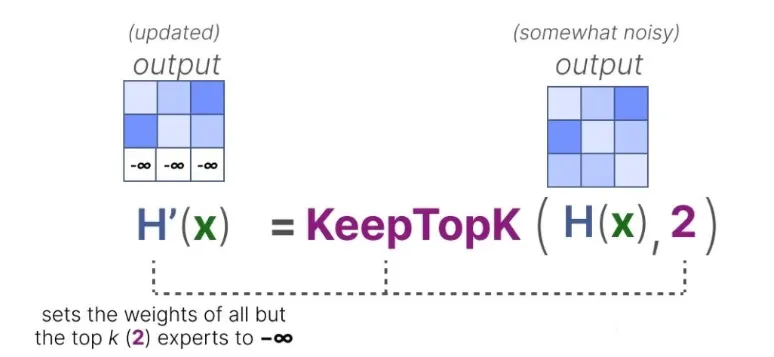
640 (23).webp
▲图-26

这样一来,在做 SoftMax 时,分数为 -∞ 的专家对应的概率就是 0,不会被选中 :
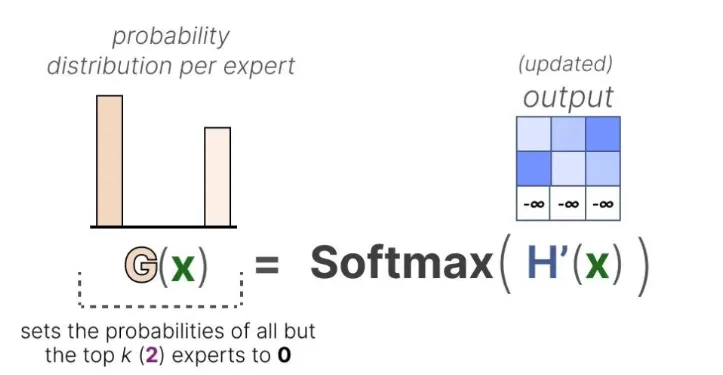
640 (24).webp
▲图-27

虽然现在也有很多好用的替代方案(新的 MoE 路由算法),但 KeepTopK 仍然是许多大型语言模型中常用的策略。

而且,它可以加噪声,也可以不加噪声,都可以使用。

  • Token Choice

KeepTopK 策略是每个 token 会被送到少数几个专家那里处理。这种方法被称为 Token Choice 。

Top-1 路由每个 token 只交给一个专家处理。
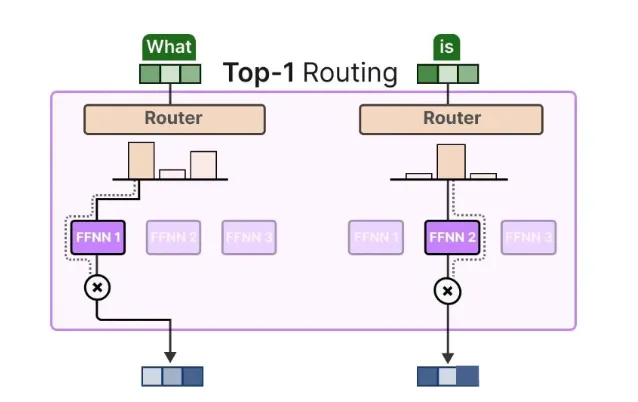
640 (25).webp
▲图-28

Top-k 路由每个 token 被同时送给k个专家,然后再根据它们的输出加权合并。
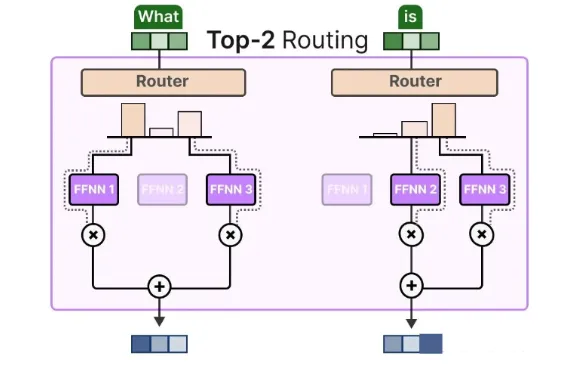
640 (26).webp
▲图-29

这种方法的优点是:可以根据每个专家的权重贡献,融合多个专家的知识,更灵活。

  • 辅助损失

为了让训练过程中的专家使用更加平均,研究者在主损失之外,引入了一个辅助损失(Auxiliary Loss),或者叫负载均衡损失(Load Balancing Loss)。

这个损失项的作用是强制每个专家在训练中有差不多的“重要性”。

总共分为三步:

(1)第一步:计算每个专家的“重要性分数

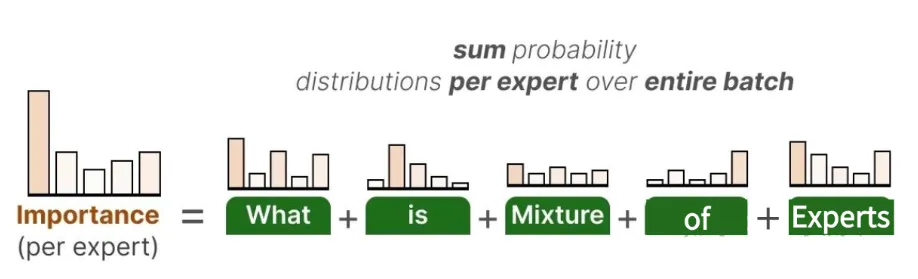
辅助损失的第一步,是对整个 batch 中每个专家的路由概率值求和也就是统计在这个 batch 中,每个专家一共“被选中的概率”加起来是多少:
640 (27).webp
▲图-30

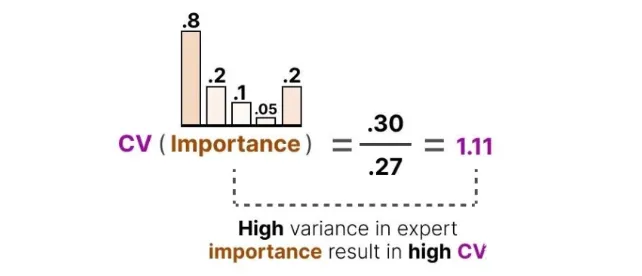
这样就得到了每个专家的一个重要性分数(importance score),表示这个专家在整个 batch 中,在不考虑输入内容的情况下,有多大可能被选中。

(2)第二步:计算“变异系数

接下来,我们可以利用这些重要性分数,计算一个指标变异系数(Coefficient of Variation, CV) ,表示各个专家的重要性差异有多大:
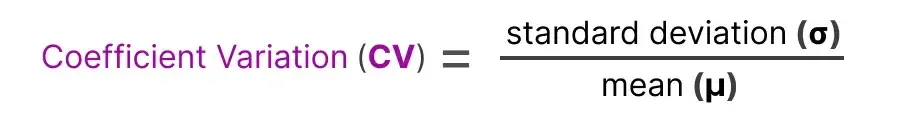
640 (28).webp
▲图-31

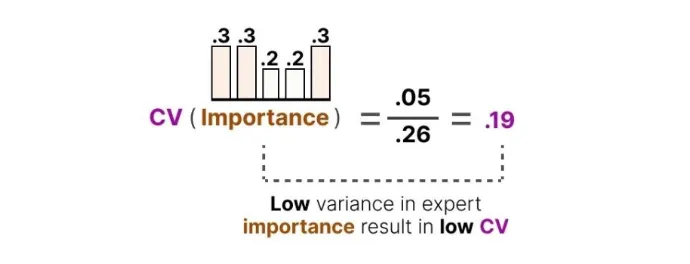
如果 CV 很高,说明某些专家总被选中,而其他专家几乎没被用;

640 (29).webp
▲图-32

如果 CV 很低,说明所有专家被使用得差不多,这正是我们想要的“负载均衡”状态。
640 (30).webp
▲图-33

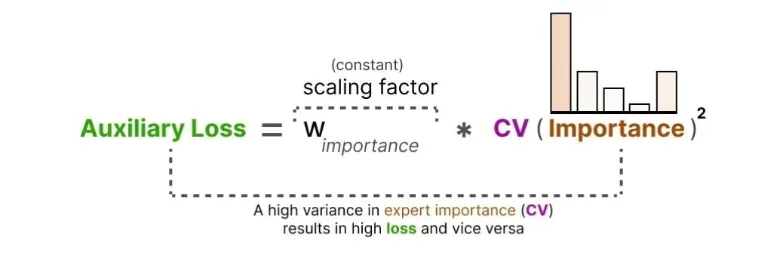
利用这个 CV 分数,我们可以在训练过程中不断更新辅助损失,使模型的优化目标之一就是尽可能降低 CV 值,从而让每个专家的使用重要性趋于一致:
640 (31).webp
▲图-34

(3)第三步:优化目标 = 降低 CV

最后,这个辅助损失会作为一个单独的损失项,加入到整体训练目标中一起优化。

专家容量

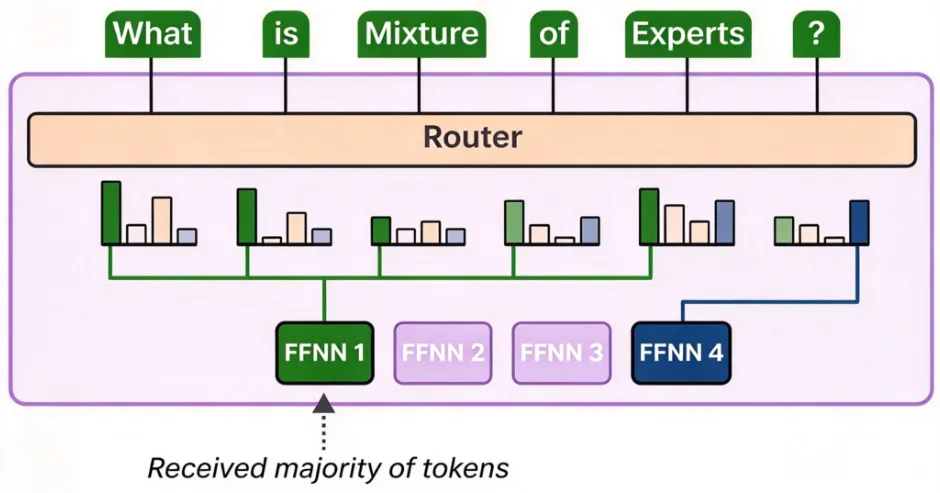
模型中的不平衡,不仅体现在被选中的专家不平均,也体现在发送给专家的 token 分布不均。

  • 比如:如果大量输入 token 都被不均衡地路由到了某一个专家(而其他专家几乎不会接收到 token),那可能会导致训练不充分。
640 (32).webp
▲图-35

所以问题不只是“用了哪个专家”,而是“每个专家被用了多少次”。

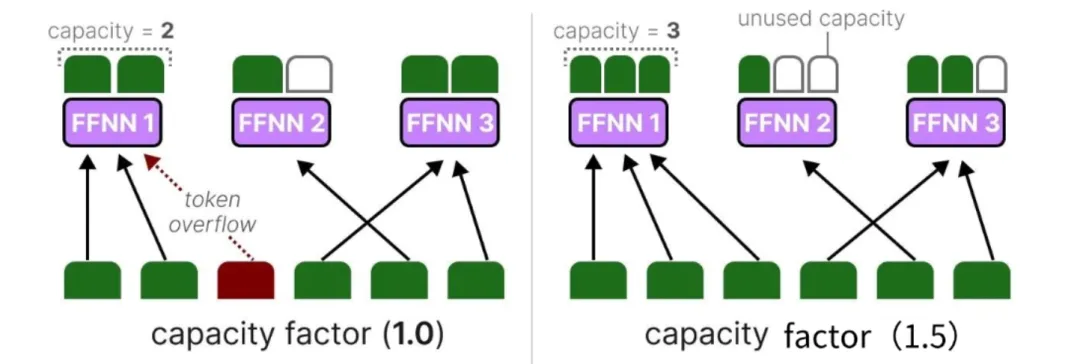
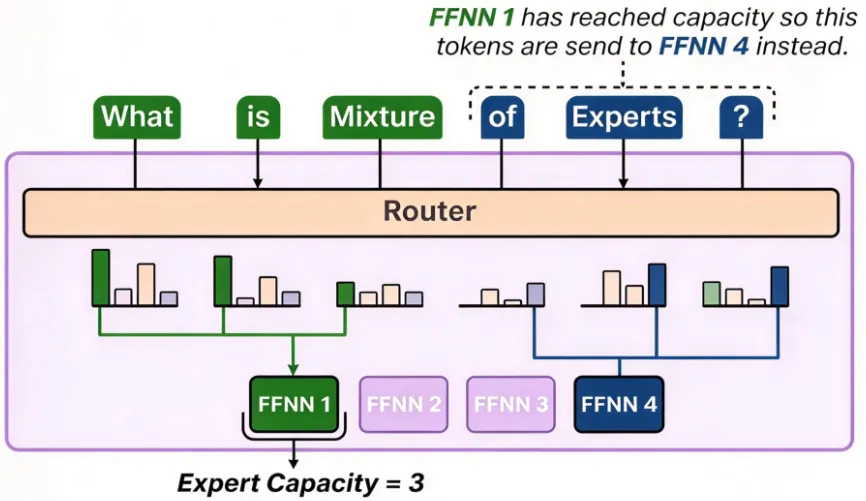
为了解决这个问题,可以引入一个限制机制,限制每个专家一次最多能处理多少个 token,称之为专家容量(Expert Capacity)。

一旦某个专家达到容量上限,剩下的 token 就会被路由给下一个候选专家:
640 (33).webp
▲图-36

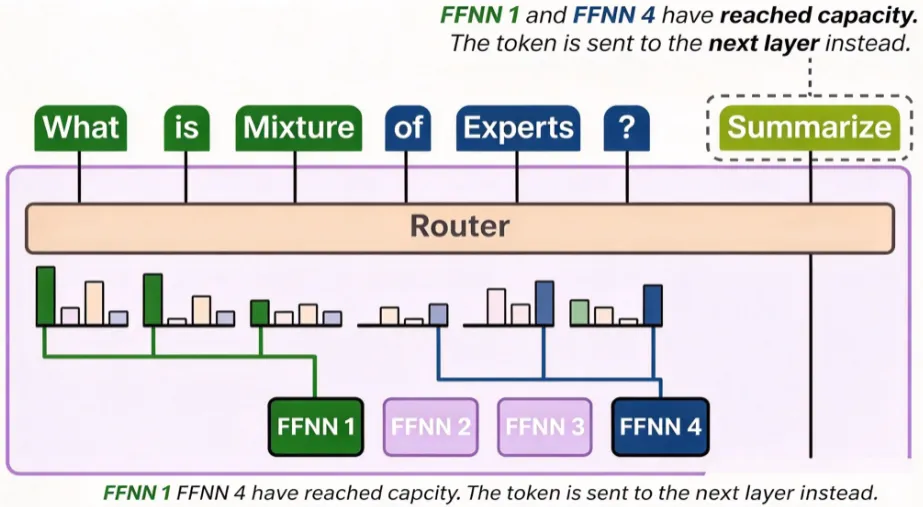
如果所有候选专家都已满,token 将不会被任何专家处理,而是跳过当前 MoE 层,进入下一层。这种情况被称为 token overflow(token 溢出) 。
640 (34).webp
▲图-37

用 Switch Transformer 简化 MoE

Switch Transformer 是最早尝试解决 MoE 模型训练不稳定问题的 Transformer 架构之一(比如前面讲过的专家负载不均衡问题)。

它简化了MoE大部分架构和训练过程,同时提高了训练稳定性。

  • 切换层

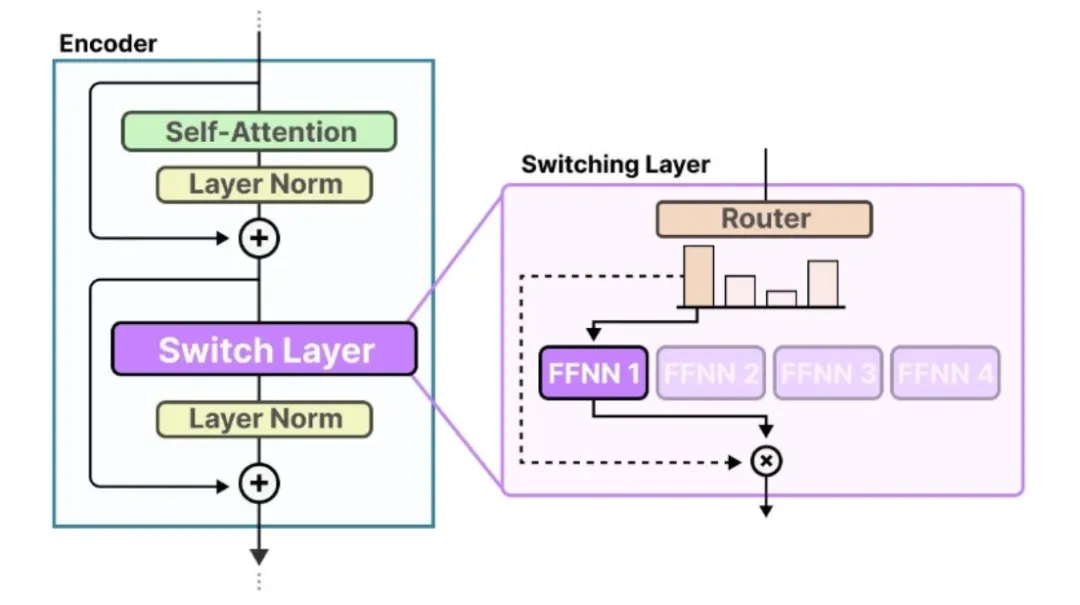
切换层(Switch Transformer) 是在T5(encoder-decoder 架构)基础上改造的模型,把传统 Transformer 中的 前馈神经网络(FFNN)层,换成了一个 Switching Layer(切换层)。

这个切换层本质上就是稀疏 MoE 层,采用Top-1 路由策略,每个 token 只被路由到一个最合适的专家上。
640 (35).webp
▲图-38

路由器没有做任何特殊技巧来计算选择哪个专家,还是用输入 token 乘上每个专家的权重,然后做一次 softmax(和我们前边说的一样,见专家选择的过程这一部分)。
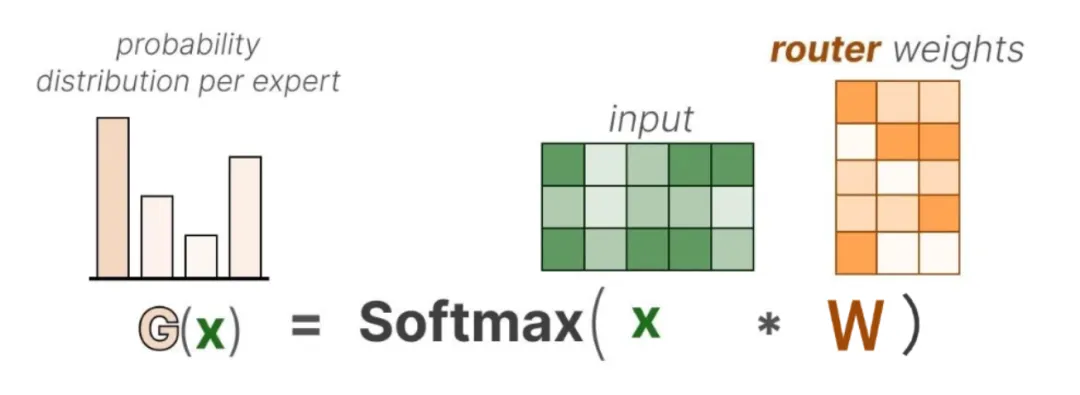
640 (36).webp
▲图-39

相比之前的 top-k 路由策略,这种结构(top-1路由)基于一个假设:每个 token 只需一个专家就够用了。

  • 专家容量因子

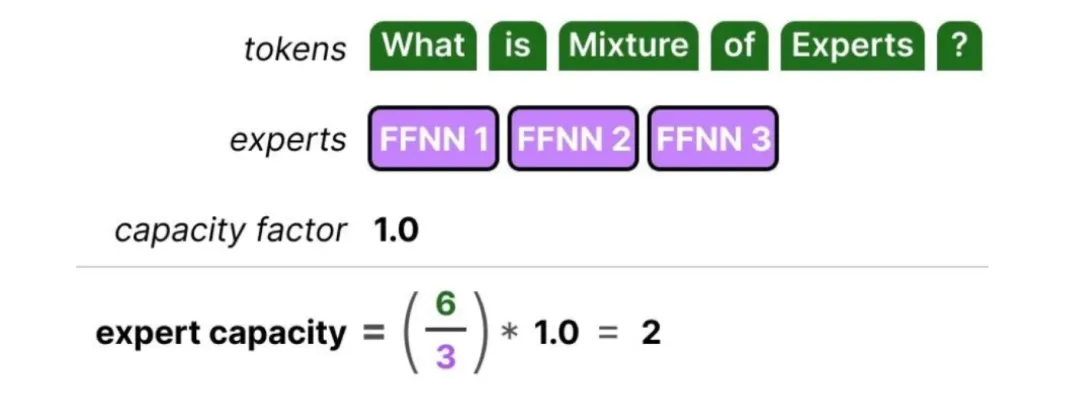
专家容量因子(Capacity Factor)是一个非常重要的超参数,它决定了每个专家最多能处理多少个 token。

Switch Transformer 对这一点做了扩展,它允许你设置专家容量因子(capacity factor),显式地控制专家容量。
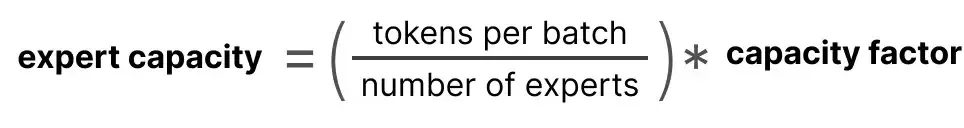
640 (37).webp
▲图-40

专家容量的组成部分很简单:

640 (38).webp
▲图-41

如果你把容量因子设置得大一点,每个专家就能处理更多的 token。

640 (39).webp
▲图-42

但是,如果容量因子太大,则会浪费计算资源。相反,如果容量因子太小,则 Token 溢出会导致模型性能下降。如果设置得太小,就可能导致很多 token 找不到专家处理,变成前面说的token 溢出 。

  • 辅助损失

为了进一步避免 token 被丢弃,Switch Transformer 引入了一个更简单版本的辅助损失函数。

这个简化的损失函数不再计算变异系数(coefficient variation),而是衡量每个专家实际被分配到的 token 的比例与路由器为该专家分配的概率之间的关系:
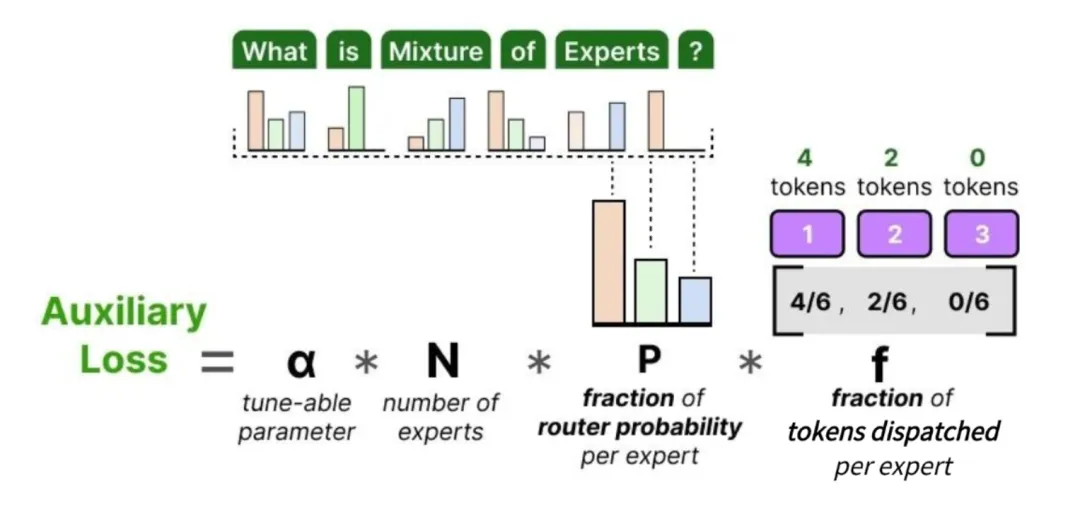
640 (40).webp
▲图-43

由于我们的目标是将 token 在 N个专家之间均匀地路由,因此希望向量 P 和 f 的值都接近 1/N 。

α 是一个超参数,用于调整辅助损失项在训练过程中的重要性。值设得太高会影响主损失函数,而值设得太低则几乎无法起到负载均衡的作用。
05.webp

视觉模型中的MoE

MoE 并不是语言模型专属的技术。

视觉模型(如 ViT)也是基于 Transformer 架构,所以也具备使用 MoE 的潜力。

快速回顾一下,ViT(Vision Transformer)是一种将图像切分成 patch(图像块)然后像处理文本 token 一样对它们进行处理的架构。
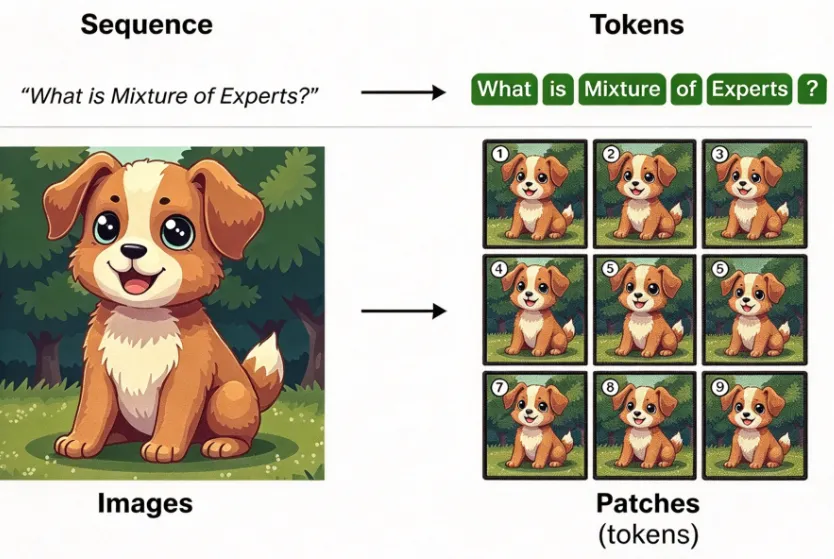
640 (41).webp
▲图-44

这些 patch(或 token)会被映射为 embedding(并加上额外的位置 embedding),然后送编码器中:
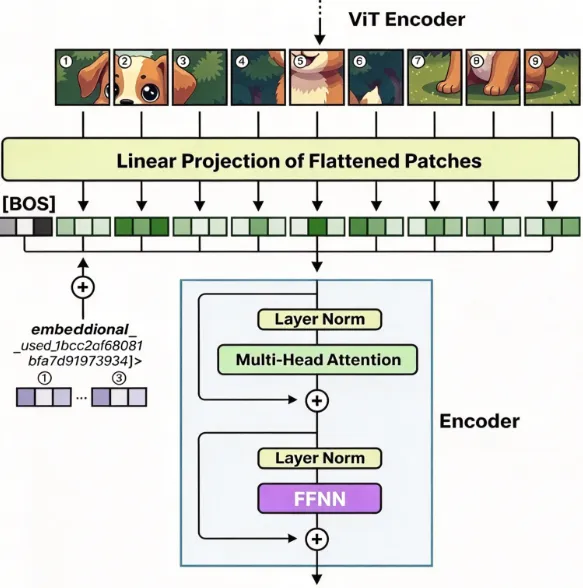
640 (42).webp
▲图-45

这些 patch 一旦进入编码器,处理方法就跟token一样了,使得这种架构非常适合引入 MoE。

Vision-MoE

Vision-MoE(V-MoE)是最早在图像模型中实现 MoE 的方案之一。

它和我们上边说的一样,以 ViT 架构为基础,用稀疏 MoE 替代了编码器中的稠密 FFNN 层。
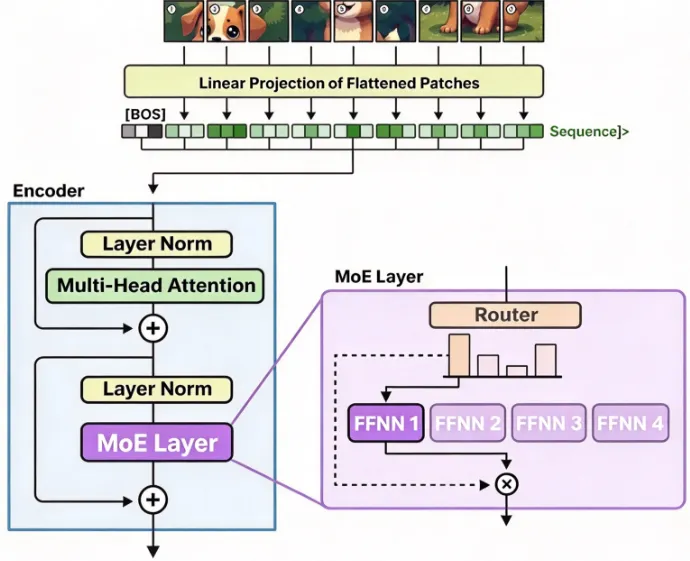
640 (43).webp
▲图-46

相较于语言模型来说,ViT模型规模相对较小,但可以通过添加专家模块进行大规模扩展。

在图像处理时,经常会将其切分为许多 patch,所以每个专家会预设一个较小容量,以此降低硬件限制。

但是预设容量太小也容易导致 patch 被丢弃(类似于 token 溢出)。
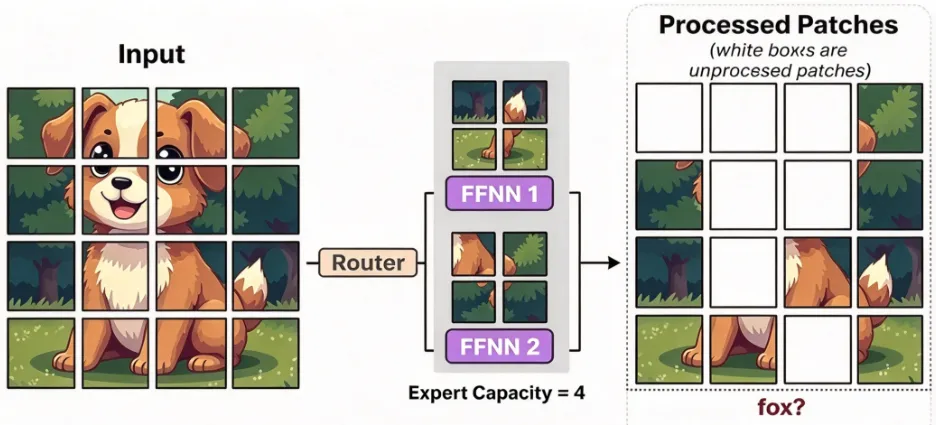
640 (44).webp
▲图-47

为了在保持低容量的同时尽可能减少关键 patch 的丢弃 ,网络会为每个 patch 设置重要性分数,优先处理重要性更高的 patch.

这样的话,溢出的那些token通常是不重要的,这种方法被称为Batch优先路由(Priority Routing)。
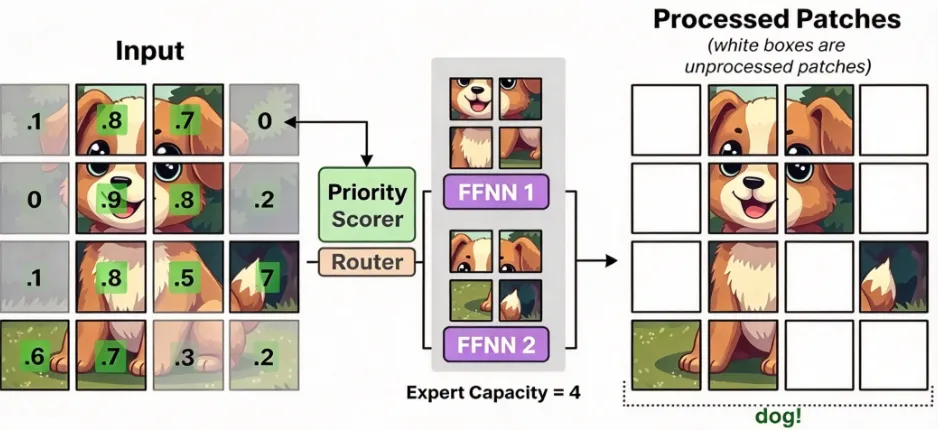
640 (45).webp
▲图-48

因此,即使一部分token消失,我们依旧可以看到重要的 patch 被优先路由到专家。
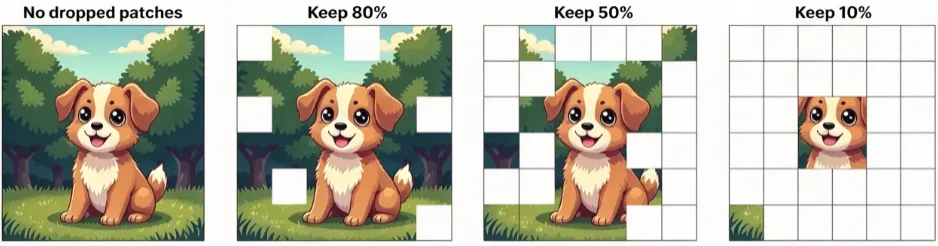
640 (46).webp
▲图-49

优先路由机制使模型即使处理较少的 patch,也能聚焦在最重要的信息上。

从稀疏 MoE 到软 MoE

在 V-MoE 中,优先评分机制有助于区分重要和不重要的 patch。然而,patch 是需要分配到各个专家处理的,没被处理的 patch 中的信息就会丢失。

Soft-MoE 目的是通过混合 patch,将离散的 patch(token)分配方式转变为更“软”的分配方式。

第一步是将输入 x(即 patch 的 embedding)乘以一个可学习矩阵 Φ 。这样我们会得到述了某个 token 与某个专家的关联程度的路由信息(router information)。
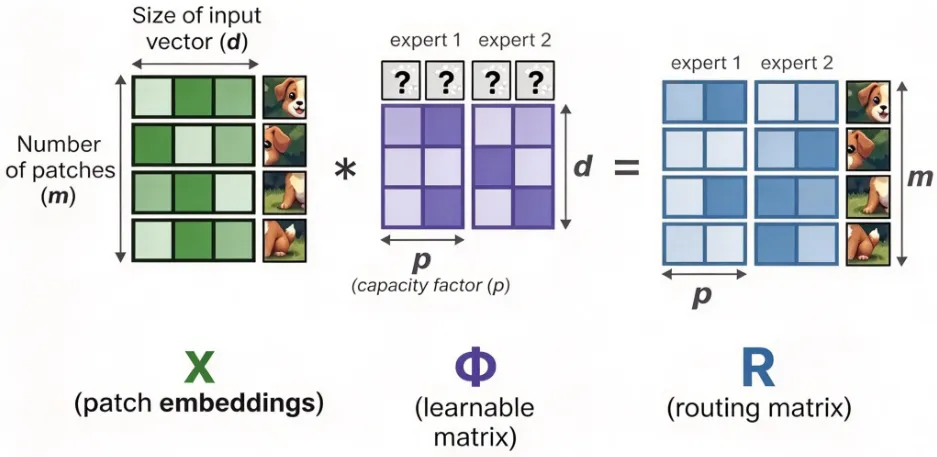
640 (47).webp
▲图-50

接着对路由信息矩阵按列做 softmax 操作,我们就可以更新每个 patch 的 embedding。
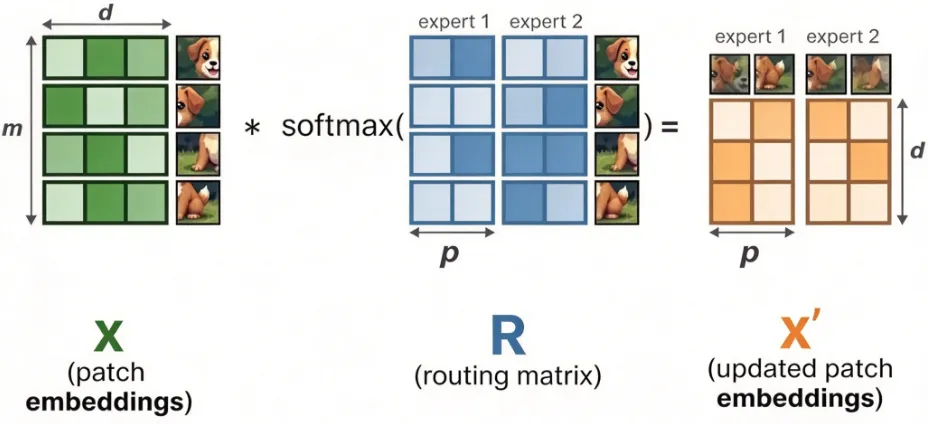
640 (48).webp
▲图-51

更新后的 patch embedding 本质上是所有 patch embedding 的加权平均。
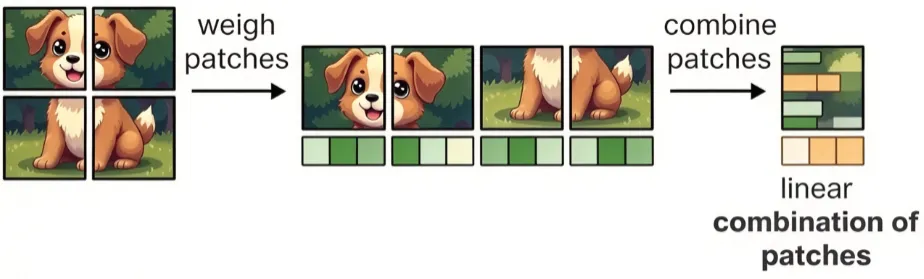
640 (49).webp
▲图-52

可视化之后可以看到,所有 patch 就好像被“混合”了。这些组合后的 patch 会被发送给每个专家,在生成输出之后,再次与路由矩阵相乘。
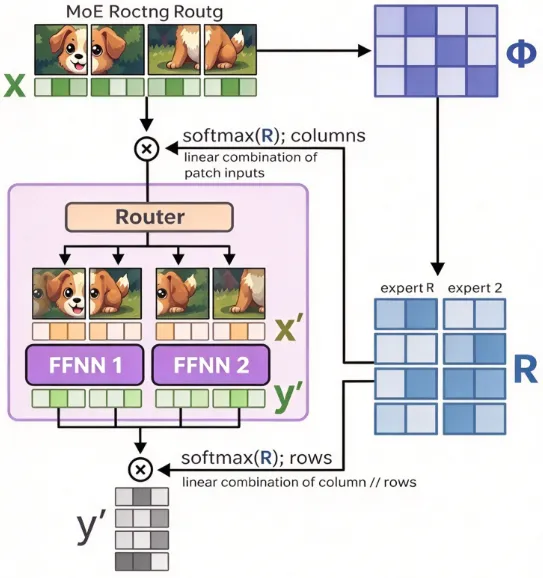
640 (50).webp
▲图-53

路由矩阵既在 token 层面影响输入,也在专家层面影响输出。

因此,我们得到的是“软”的 patch/token,而不是离散的输入。
06.webp

活动参数 vs 稀疏参数:以 Mixtral 8x7B 为例

MoE 火起来的一个关键优势是节省计算资源。

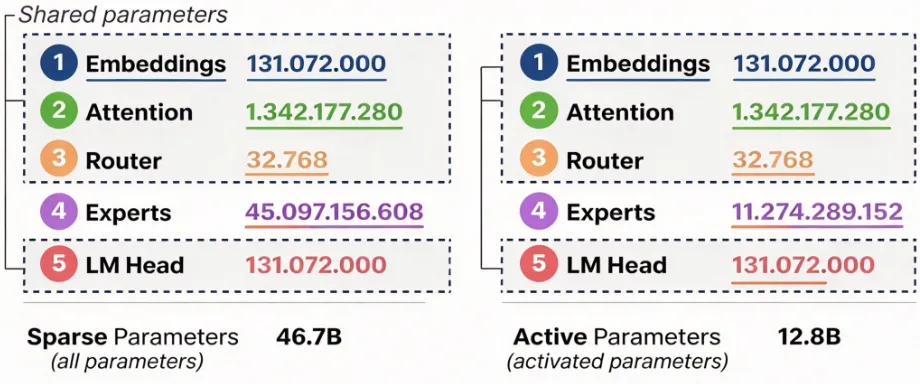
虽然某个 MoE 模型看起来好像有更多参数(稀疏参数),但在推理时只激活其中一部分活动参数(active parameters)。
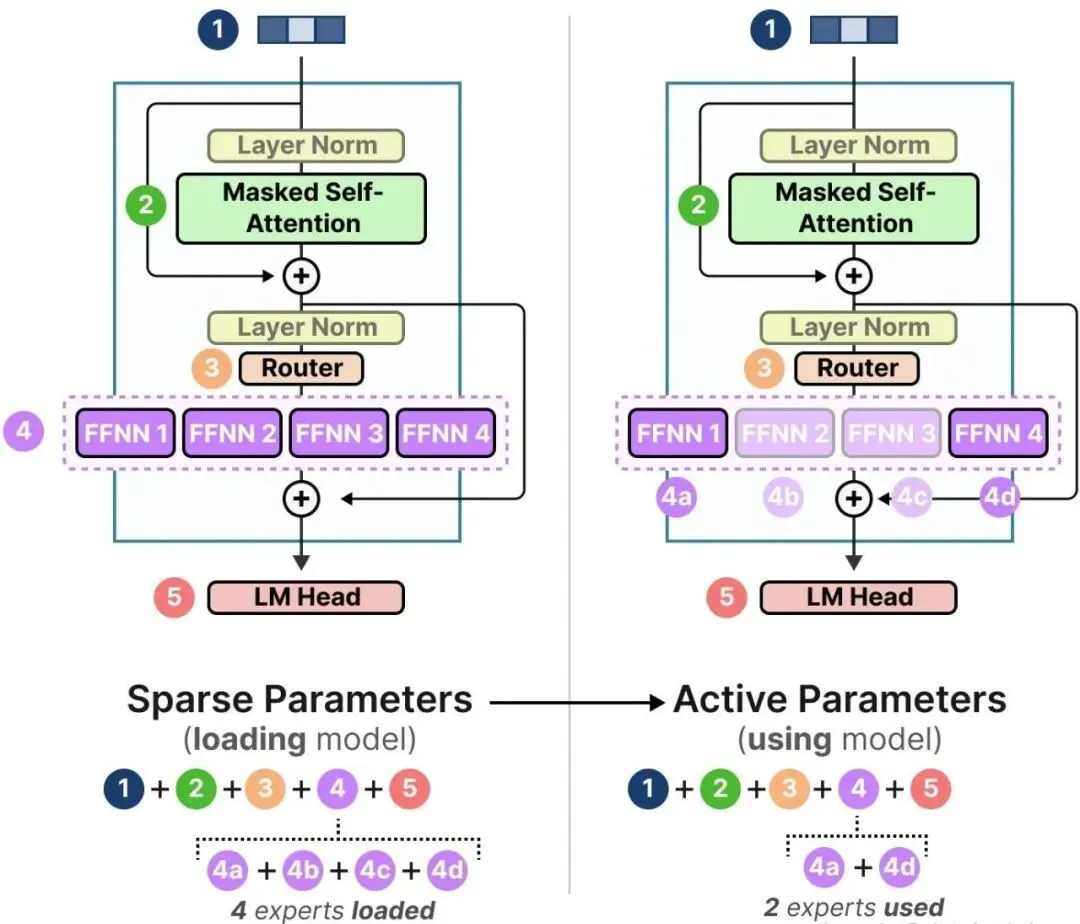
640 (51).webp
▲图-54

换句话说,我们仍然需要将整个模型(包括所有专家)加载到设备上(稀疏参数),但在推理时,只需使用其中的一部分(激活参数)。

也就是说MoE 模型需要更多的显存(VRAM)来加载所有专家,但推理更快,因为每次只用一小部分专家。

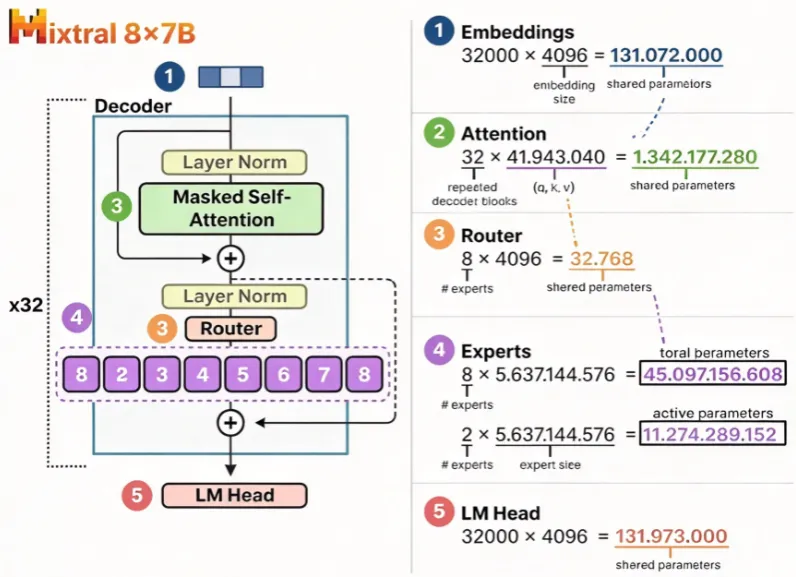
  • 我们来看一个例子:Mixtral 8x7B,来比较稀疏参数和互动参数的数量。
640 (52).webp
▲图-55

在这个模型中,每个专家的大小是 5.6B,而不是 7B。

640 (53).webp
▲图-56

我需要加载 8×5.6…B ≈ 45.1B 的参数(原文为 46.7B,是因为加上了共享参数),但在推理时实际只使用了 2×5.6…B ≈ 11.3B 的参数。

因此,Mixtral 8x7B 表面上是一个“大模型”,但每次推理只用了“小模型”的算力。

这正是 MoE 架构兼顾“能力”和“效率”的核心所在。
07.webp

代码实现


"""混合专家模型(Mixture of Experts, MoE)实现代码参考:https://github.com/jingyaogong/minimind/blob/master/model/model_minimind.py"""import mathimport torchfrom torch import nnfrom transformers.activations import ACT2FNimport torch.nn.functional as Ffrom transformers import PretrainedConfigclass Config(PretrainedConfig):    """MoE模型的配置类,继承自Hugging Face的PretrainedConfig"""    def __init__(            self,            dropout: float = 0.0,            hidden_act: str = 'silu',            hidden_size: int = 512,            intermediate_size: int = None,            num_experts_per_tok: int = 2,            n_routed_experts: int = 4,            n_shared_experts: int = 1,            scoring_func: str = 'softmax',            aux_loss_alpha: float = 0.1,            seq_aux: bool = True,            norm_topk_prob: bool = True,            **kwargs    ):        """        初始化MoE配置        Args:            dropout: Dropout率            hidden_act: 激活函数类型            hidden_size: 隐藏层维度            intermediate_size: 中间层维度,如为None则自动计算            num_experts_per_tok: 每个token选择的专家数量            n_routed_experts: 总的专家数量            n_shared_experts: 共享专家数量            scoring_func: 评分函数类型,默认为'softmax'            aux_loss_alpha: 辅助损失的alpha参数            seq_aux: 是否在序列级别计算辅助损失            norm_topk_prob: 是否标准化top-k概率        """        super().__init__(**kwargs)        self.dropout = dropout        self.hidden_act = hidden_act        self.hidden_size = hidden_size        self.intermediate_size = intermediate_size        self.num_experts_per_tok = num_experts_per_tok            self.n_routed_experts = n_routed_experts                  self.n_shared_experts = n_shared_experts                  self.scoring_func = scoring_func                          self.aux_loss_alpha = aux_loss_alpha                      self.seq_aux = seq_aux                                    self.norm_topk_prob = norm_topk_prob              class FeedForward(nn.Module):    """前馈神经网络模块"""    def __init__(self, config: Config):        super().__init__()        # 如果未指定中间层维度,则自动计算(基于隐藏层维度的8/3倍)        if config.intermediate_size is None:            intermediate_size = int(config.hidden_size * 8 / 3)            # 将中间层维度对齐到64的倍数,优化内存访问            config.intermediate_size = 64 * ((intermediate_size + 64 - 1) // 64)        # 定义网络层        self.gate_proj = nn.Linear(config.hidden_size, config.intermediate_size, bias=False)        self.down_proj = nn.Linear(config.intermediate_size, config.hidden_size, bias=False)        self.up_proj = nn.Linear(config.hidden_size, config.intermediate_size, bias=False)        self.dropout = nn.Dropout(config.dropout)        self.act_fn = ACT2FN[config.hidden_act]  # 激活函数    def forward(self, x):        # 使用门控激活机制:gate_proj(x) * up_proj(x)        return self.dropout(self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x)))class MoEGate(nn.Module):    """MoE门控机制,负责专家选择和权重分配"""    def __init__(self, config: Config):        super().__init__()        self.config = config        self.top_k = config.num_experts_per_tok          self.n_routed_experts = config.n_routed_experts          self.scoring_func = config.scoring_func          self.alpha = config.aux_loss_alpha               self.seq_aux = config.seq_aux                   self.norm_topk_prob = config.norm_topk_prob          self.gating_dim = config.hidden_size                 self.weight = nn.Parameter(torch.empty((self.n_routed_experts, self.gating_dim)))        self.reset_parameters()    def reset_parameters(self) -> None:        """使用Kaiming均匀分布初始化权重参数"""        import torch.nn.init as init        init.kaiming_uniform_(self.weight, a=math.sqrt(5))    def forward(self, hidden_states):        """        Args:            hidden_states: 输入隐藏状态          Returns:            topk_idx: 选择的专家索引            topk_weight: 专家权重            aux_loss: 辅助损失        """        # 获取输入形状        bsz, seq_len, h = hidden_states.shape        # 展平输入:(batch_size * seq_len, hidden_size)        hidden_states = hidden_states.view(-1, h)        # 计算专家得分:每个token对每个专家的偏好分数        logits = F.linear(hidden_states, self.weight, None)        # 使用softmax将得分转换为概率分布        if self.scoring_func == 'softmax':            scores = logits.softmax(dim=-1)        else:            raise NotImplementedError(f'insupportable scoring function for MoE gating: {self.scoring_func}')        # 选择top-k专家和对应的权重        topk_weight, topk_idx = torch.topk(scores, k=self.top_k, dim=-1, sorted=False)        # 如果选择多个专家且需要标准化概率,则进行归一化        if self.top_k > 1 and self.norm_topk_prob:            denominator = topk_weight.sum(dim=-1, keepdim=True) + 1e-20  # 避免除零            topk_weight = topk_weight / denominator        # 计算辅助损失(仅在训练时且alpha>0时计算)        if self.training and self.alpha > 0.0:            scores_for_aux = scores            aux_topk = self.top_k            topk_idx_for_aux_loss = topk_idx.view(bsz, -1)            if self.seq_aux:                # 序列级别的辅助损失计算                scores_for_seq_aux = scores_for_aux.view(bsz, seq_len, -1)                ce = torch.zeros(bsz, self.n_routed_experts, device=hidden_states.device)                ce.scatter_add_(1, topk_idx_for_aux_loss,                                torch.ones(bsz, seq_len * aux_topk, device=hidden_states.device)).div_(                    seq_len * aux_topk / self.n_routed_experts)                aux_loss = (ce * scores_for_seq_aux.mean(dim=1)).sum(dim=1).mean() * self.alpha            else:                # token级别的辅助损失计算                mask_ce = F.one_hot(topk_idx_for_aux_loss.view(-1), num_classes=self.n_routed_experts)                ce = mask_ce.float().mean(0)                Pi = scores_for_aux.mean(0)                fi = ce * self.n_routed_experts                aux_loss = (Pi * fi).sum() * self.alpha        else:            aux_loss = 0        return topk_idx, topk_weight, aux_lossclass MOEFeedForward(nn.Module):    def __init__(self, config: Config):        super().__init__()        self.config = config        # 创建专家网络列表        self.experts = nn.ModuleList([            FeedForward(config)            for _ in range(config.n_routed_experts)        ])        # 创建门控模块        self.gate = MoEGate(config)        # 如果配置了共享专家,则创建共享专家网络        if config.n_shared_experts > 0:            self.shared_experts = nn.ModuleList([                FeedForward(config)                for _ in range(config.n_shared_experts)            ])    def forward(self, x):        identity = x  # 保存原始输入用于残差连接        orig_shape = x.shape        bsz, seq_len, _ = x.shape        # 使用门控机制选择专家        topk_idx, topk_weight, aux_loss = self.gate(x)        x = x.view(-1, x.shape[-1])        flat_topk_idx = topk_idx.view(-1)        # 训练和推理使用不同的处理策略        if self.training:            # 训练模式:为每个token复制输入,分别处理            x = x.repeat_interleave(self.config.num_experts_per_tok, dim=0)            y = torch.empty_like(x, dtype=torch.float16)            # 对每个专家处理其负责的token            for i, expert in enumerate(self.experts):                y[flat_topk_idx == i] = expert(x[flat_topk_idx == i]).to(y.dtype)  # 确保类型一致            # 加权合并专家输出            y = (y.view(*topk_weight.shape, -1) * topk_weight.unsqueeze(-1)).sum(dim=1)            y = y.view(*orig_shape)        else:            # 推理模式:使用优化的推理方法            y = self.moe_infer(x, flat_topk_idx, topk_weight.view(-1, 1)).view(*orig_shape)        # 如果配置了共享专家,则添加共享专家的输出        if self.config.n_shared_experts > 0:            for expert in self.shared_experts:                y = y + expert(identity)        # 保存辅助损失用于反向传播        self.aux_loss = aux_loss        return y    @torch.no_grad()    def moe_infer(self, x, flat_expert_indices, flat_expert_weights):        expert_cache = torch.zeros_like(x)        # 对专家索引进行排序,便于批量处理        idxs = flat_expert_indices.argsort()        # 计算每个专家处理的token数量        tokens_per_expert = flat_expert_indices.bincount().cpu().numpy().cumsum(0)        # 计算对应的token索引        token_idxs = idxs // self.config.num_experts_per_tok        # 对每个专家批量处理其负责的token        for i, end_idx in enumerate(tokens_per_expert):            start_idx = 0 if i == 0 else tokens_per_expert[i - 1]            if start_idx == end_idx:                continue            expert = self.experts[i]            exp_token_idx = token_idxs[start_idx:end_idx]            expert_tokens = x[exp_token_idx]            # 专家处理并加权            expert_out = expert(expert_tokens).to(expert_cache.dtype)            expert_out.mul_(flat_expert_weights[idxs[start_idx:end_idx]])            # 将结果累加到缓存中            expert_cache.scatter_add_(0, exp_token_idx.view(-1, 1).repeat(1, x.shape[-1]), expert_out)        return expert_cache
08.webp
总结

至此,本文关于混合专家模型的介绍就告一段落了。

如今,几乎所有模型中都至少包含一个MoE变体, 看起来,MoE 已经不再是尝试性的选择,而是将长期存在的关键技术之一。

希望篇文章能够对立学习和理解MoE有所帮助。

文章经作者 @PennHu 授权分享

~【91探花】技术交流群~


💪致力于帮助各位朋友「打破隐形的墙」,共建一个更自由、更有深度、更有价值的交流生态社区!在各大企业工作的,可以相互内推,互通有无;在学校读研读博的,可以交流想法,携手合作。

扫码添加阿蓝,选择想要加入的交流群即可

(按照提交顺序邀请,请尽早选择)

👇
image.png