杨立昆团队在JEPA世界模型的研究上,从图像、视频、无人机控制,进一步延伸到端到端自动驾驶领域。
这篇AD‑E2E‑JEPA论文瞄准一个很现实的工程痛点:现有的JEPA自动驾驶世界模型陷入两难,一部分模型规划精度尚可,但单场景规划耗时动辄一分钟以上,完全无法实车部署;另一类推理速度快,做规划任务的精度又不够。
过去端到端自动驾驶绝大多数方案依赖模仿学习,直接拟合人类驾驶员轨迹。这类反应式策略不显示建模环境动力学,容易被噪声、非最优人类演示数据拖累性能。而JEPA世界模型的思路不一样:它在隐空间做预测,不去重建像素,通过推演不同候选动作带来的未来表征,完成规划决策。
不过已有的LeWM、DINO‑WM、JEPA‑WM这些JEPA自动驾驶基线,没有平衡好推理开销和规划能力,很难真正走向实车。
AD‑E2E‑JEPA给出的解法是引入带SIGReg正则的可学习投影器,在压缩表征的同时保留规划需要的关键信息,实现百倍推理加速,并且这套预训练投影器还可以给下游模仿学习任务做增益。
传统JEPA世界模型直接使用编码器输出的稠密Patch特征做规划,Patch数量大、特征维度高,每一条候选轨迹都要做自回归推演,算力开销居高不下。AD‑E2E‑JEPA的改动集中在特征处理环节,整体架构见下图。
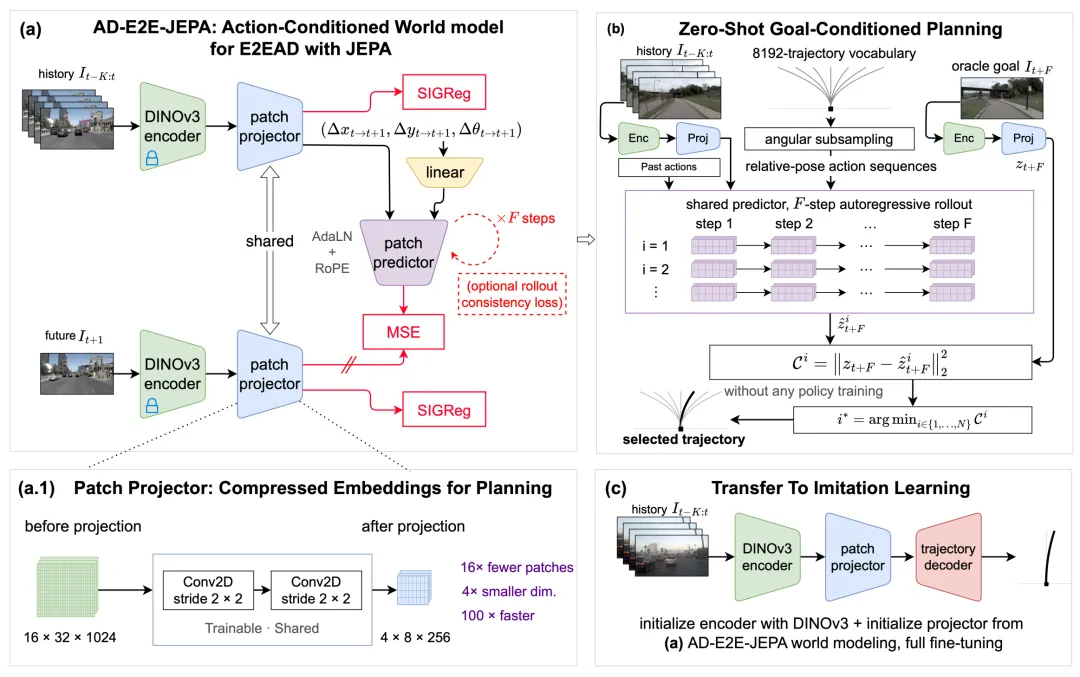
图| AD‑E2E‑JEPA架构图©【深蓝AI】编译
它复用冻结的DINOv3作为视觉编码器,新增一个由两个步长为2×2卷积层构成的共享可学习Patch投影器。经过投影之后,Patch数量压缩16倍,嵌入维度从1024降低至256,维度压缩4倍。这一步压缩是百倍加速的来源,但压缩操作会带来风险:网络容易出现表征坍缩,不同的视觉输入被映射成几乎一致的向量,彻底丢失区分信息。
为了解决坍缩,论文引入SIGReg正则约束。不同于过往工作把SIGReg作用于全局CLS token,本文直接对每一个Patch位置、每一个时间步施加SIGReg,约束隐表征逼近各向同性高斯分布,维持表征多样性。
这套架构有两条使用路径:
-
零样本条件目标规划:完全不去训练驾驶策略网络。给定历史图像,遍历轨迹词库里面的候选轨迹,用世界模型自回归推演得到未来隐向量,选出和目标图像隐向量距离最小的轨迹作为输出;
-
迁移到模仿学习:扔掉Patch预测器,保留预训练好的DINOv3编码器+投影器,接上轨迹解码器做微调,把世界模型学到的表征能力赋能模仿学习。
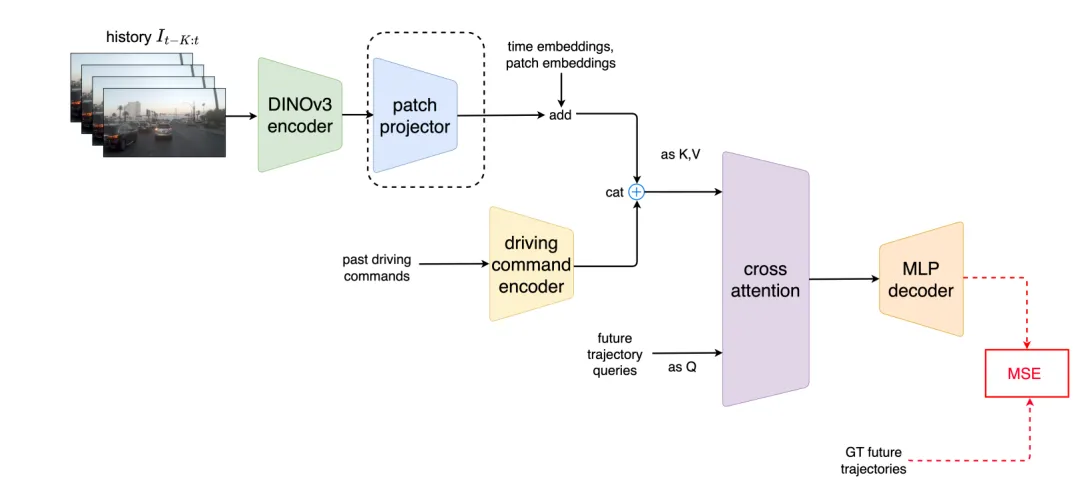
图| 下游模仿学习架构©【深蓝AI】编译
零样本规划的任务逻辑
这里的零样本规划不是指现实世界开放域零样本,是不训练驾驶策略网络,仅依靠世界模型推演完成规划。目标是未来时刻的相机观测图像,候选轨迹来自预定义轨迹词库,规模可以选择256、512直到8192条。
论文设计一套完整评测指标,不止看最终得分,同时覆盖驾驶性能、规划耗时、位姿误差、命中成功率:
-
EPDMS / EPDMS†:NAVSIMv2基准指标。EPDMS包含乘法安全指标,EPDMS†剔除安全项,只评估驾驶质量。要客观看待该指标:零样本规划没有针对安全规则做显式优化,EPDMS的安全相关项天然会偏弱,所以EPDMS†更适合衡量世界模型本身推演质量;
-
FDE、Δx、Δy、Δθ:最终位姿位移误差,衡量推演出来轨迹和真值轨迹的几何偏差;
-
Hit rate(命中率):判断真值轨迹能不能排进代价最小的Top‑1/Top‑5候选,反映世界模型推演的可靠性。该指标有一个天然局限:候选轨迹总数越大,命中率天然会下降,不能孤立看命中率高低,需要结合候选数量一起解读。
数据集采用NAVSIMv2,分别在100个抽样测试场景,以及完整12146条测试序列开展评测。基线包含LeWM、DINO‑WM、JEPA‑WM。
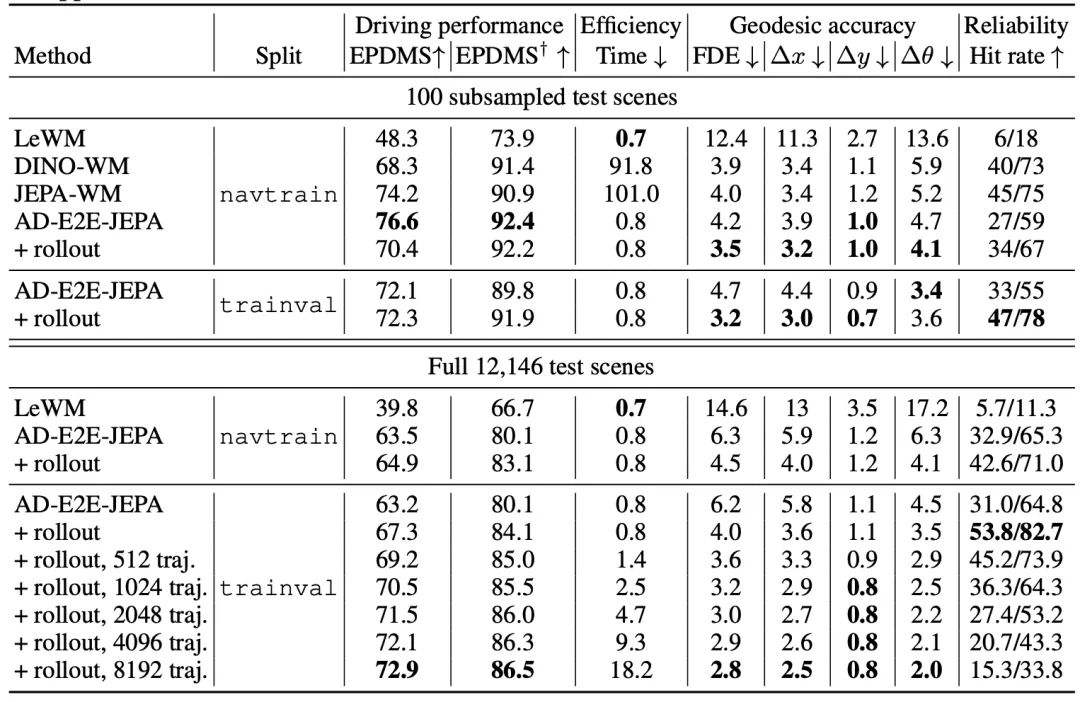
表| NAVSIM数据集上零样本条件目标规划结果©【深蓝AI】编译
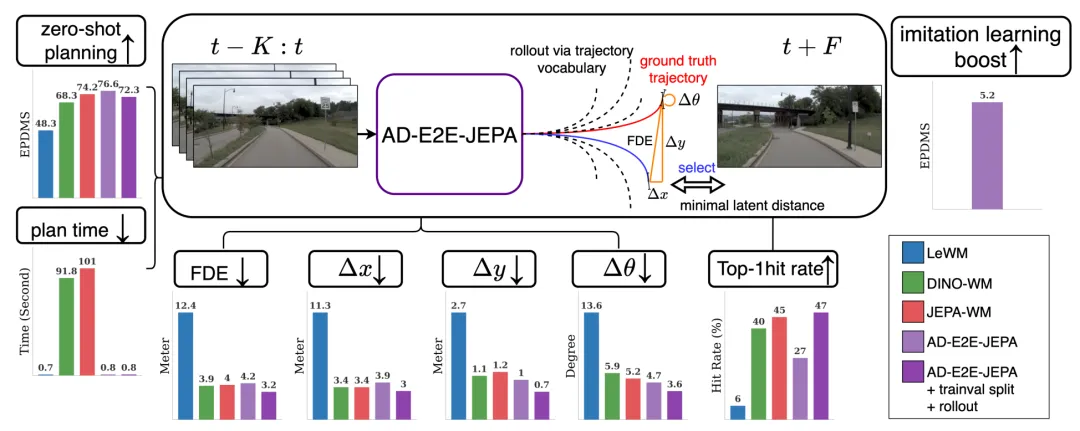
可以清晰看到基线的矛盾:DINO‑WM、JEPA‑WM规划效果优秀,但单场景规划耗时接近100秒,完整数据集评测几乎不可行,完全达不到自动驾驶实时性硬性约束;LeWM速度快,但几何误差巨大,FDE达到12.4米,规划基本不可用。
AD‑E2E‑JEPA(开启rollout损失,256候选轨迹)仅需要0.8秒每场景,实现约100倍推理加速,FDE为3.2m,Top‑1命中率47%,已经追上DINO‑WM、JEPA‑WM的规划水平。
随着候选轨迹数量从256提升到8192,模型可以选择更精细的轨迹:EPDMS提升至72.9,FDE进一步下降到2.8m。但代价也很直接:规划时间上涨至18.2秒,同时候选变多,Top‑1命中率下滑至15.3%。
客观现实:候选轨迹数量是一组权衡。少量候选可以做到实时,但轨迹集合粒度粗,上限有限;海量候选轨迹精度更高,但实时性被破坏,不能直接用于实车在线规划。
再看模仿学习迁移的结果:
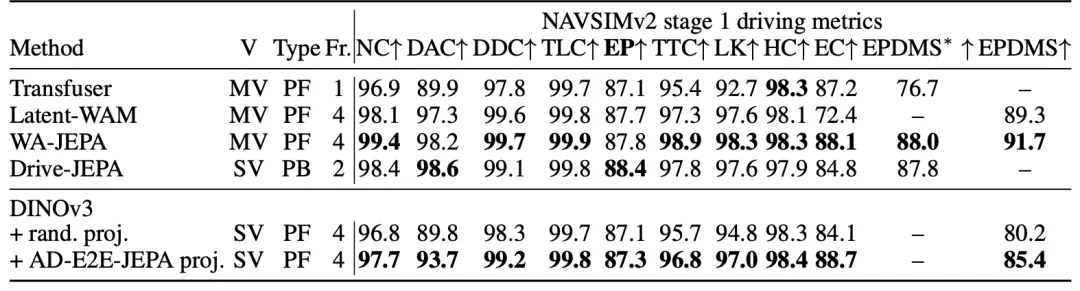
表| NAVSIMv2 navtest‑stage‑1基准©【深蓝AI】编译
仅仅复用世界模型阶段自监督预训练得到的投影器,其余编码器主干保持不变,下游模仿学习EPDMS从80.2提升至85.4。这说明,世界模型学到的压缩表征,包含了对自动驾驶有价值的环境动力学信息,能够给传统模仿学习带来增益。这是一个有意思的结论:世界模型不只是用来做规划,预训练出来的组件也可以给传统反应式端到端模型做增强。
差异化优势
-
打通JEPA自动驾驶世界模型的速度‑精度矛盾。过去JEPA自动驾驶世界模型只能做离线实验,AD‑E2E‑JEPA依靠投影压缩+SIGReg正则,在不显著损失规划能力前提下,实现百倍加速,让JEPA世界模型向在线部署迈出一步;
-
把世界模型能力和模仿学习打通。大多数JEPA自动驾驶研究聚焦零样本规划,本文验证了世界模型预训练模块可以迁移给模仿学习,证明动力学表征可以赋能反应式驾驶模型;
-
评测体系更完整。不只看EPDMS分数,引入FDE、命中率、规划耗时多维度,不再单纯依靠仿真打分,能看清模型推演的真实几何可靠性。
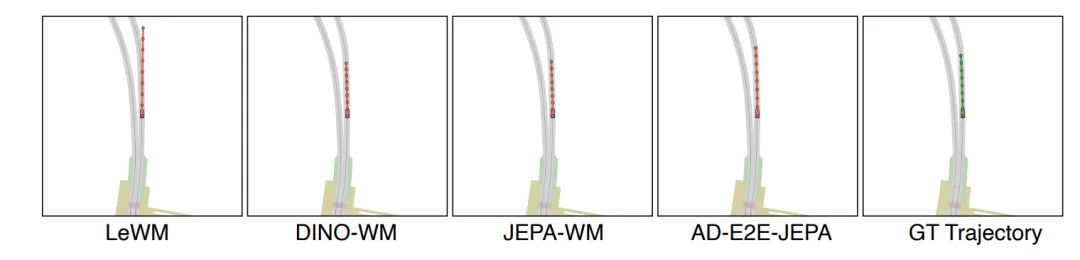
图| 零样本目标条件规划定性对比图©【深蓝AI】编译
不可忽略的局限,也是后续待解决的方向
-
零样本规划不等于真正实车零样本泛化。这里的零样本指“不训练驾驶策略网络”,模型依旧在NAVSIM数据集上完成自监督预训练,并不是随便拿到陌生城市直接跑;同时规划是从固定轨迹词库做选择,不生成全新轨迹,输出上限受轨迹词库约束;
-
实时性和精度依旧存在权衡。256候选可以做到0.8秒,但是轨迹粒度有限;想要更高精度就要增加候选数量,推理时间随之暴涨,距离车载硬件上高频(几十毫秒级)在线规划还有距离;
-
安全属于间接派生结果。整个训练目标没有显式优化碰撞、交规等安全约束。EPDMS里面安全项来自仿真打分,世界模型本身不懂得安全规则,只是靠表征距离选出轨迹,会存在潜在安全风险;
-
输入仅使用单目相机,没有融合激光雷达等其他传感器;实验全部在NAVSIM仿真数据集完成,没有真实车辆路测结果,仿真和真实世界之间的域差问题没有验证。
端到端自动驾驶有两条主流路线:一条是模仿学习,训练反应式策略;另一条是世界模型,推演未来环境状态再做规划。JEPA系列世界模型一直有很好的理论潜力,但稠密Patch带来巨大算力开销,一直阻碍落地。
AD‑E2E‑JEPA给出一条可行的折中路线:通过卷积投影器压缩Patch表征,SIGReg正则防止坍缩,以很小的性能损失换取百倍推理速度。它不止实现目标条件零样本规划,还证实世界模型预训练表征能够增益模仿学习,把两条端到端路线连接起来。
当然它还处于研究阶段,距离真正上车还有不少鸿沟:真实世界域迁移、更高频推理速度、显式安全约束、多传感器融合,都是接下来需要攻克的问题。但这项工作证明,JEPA类隐空间世界模型,有机会走出纯离线仿真验证,朝着自动驾驶在线规划方向继续推进。
编辑|小小怪博士
审核|阿蓝
参考论文:
论文标题:AD‑E2E‑JEPA: A JOINT‑EMBEDDING PREDICTIVE ARCHITECTURE FOR END‑TO‑END AUTONOMOUS DRIVING
论文链接:https://arxiv.org/pdf/2609.34085
项目链接:https://github.com/HaoranZhuExplorer/AD-E2E-JEPA
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇