现在基于视频大模型的无人机导航,大多走“先生成未来视频画面,再从视频重建相机运动”的技术链路,典型代表就是NavDreamer。但整套流程开销巨大:图像渲染、像素级解码、多帧几何重建会吃掉大量算力,而无人机真正需要的只是相机运动轨迹,画面纹理、色彩细节对于飞控来说属于无效信息。
浙大高飞团队联合微分智飞提出的DiffWAM给出一条不一样的技术路径:不需要在线输出完整未来视频,直接复用冻结视频世界模型的多层中间预测特征,搭配单帧图像几何信息,解码输出连续的无人机SE(3)相机轨迹。
在DiffWAM‑1000基准测试集上轨迹RMSE达到0.3492 m,端点任务成功率74.40%;衍生轻量化版本DiffWAM‑Flash在Jetson AGX Thor机载板卡模型流水线延迟仅1.08 s。
真机完成绕飞、S形机动、狭缝穿越、多阶段复合导航,证明视频模型蕴藏的运动知识可以绕开视频生成环节直接提取,给机载语言驱动无人机导航提供低算力备选方案。
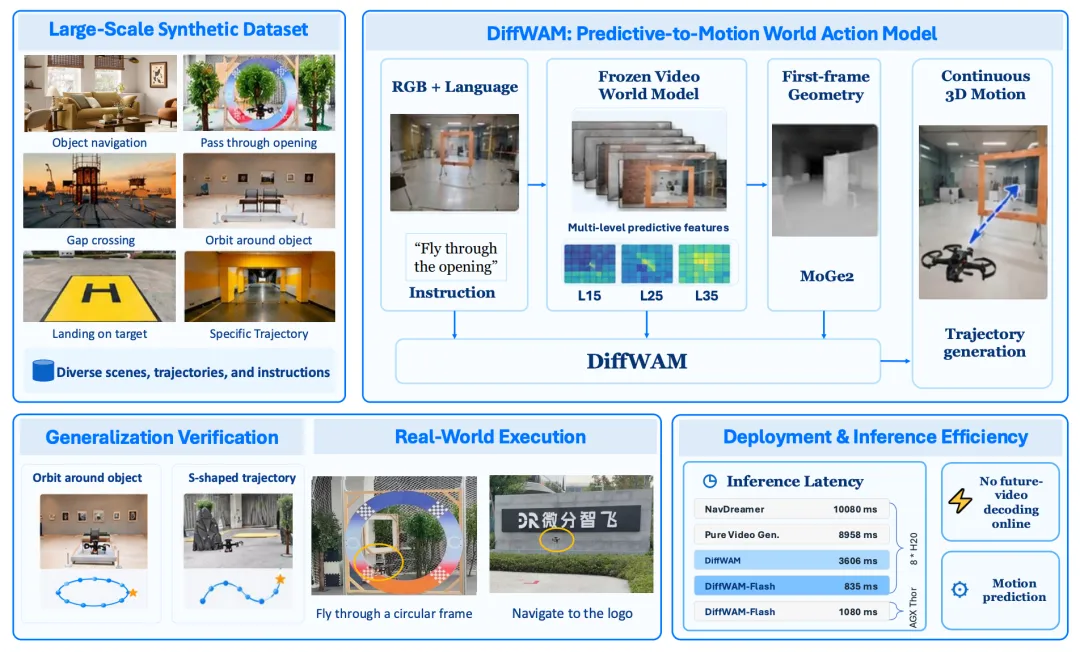
图 | DiffWAM总览图 ©【深蓝AI】编译
DiffWAM整套架构的核心思路:不等视频生成全部完成,在视频扩散去噪的早期阶段截取多层隐层特征,依靠Grid‑Motion模块保留时空运动关联,再通过Latent2Pose模块结合首帧单目几何MoGe2输出度量尺度下的完整相机轨迹。
视频主干网络、几何估计器全程冻结,只训练轨迹读取头。训练阶段才会用到完整视频推演做离线监督,部署阶段彻底砍掉视频VAE解码、多帧重建步骤。
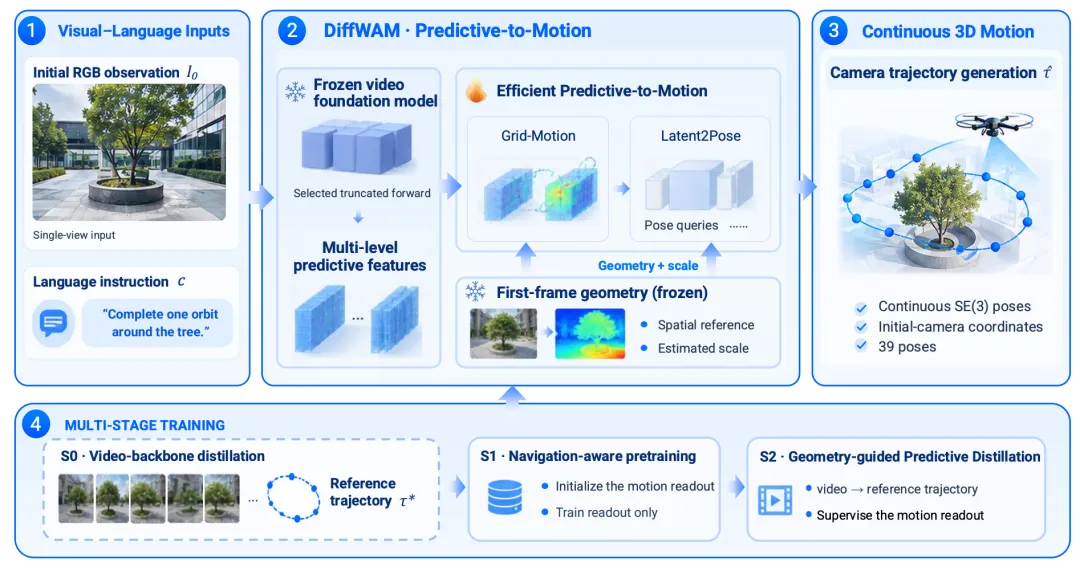
图 | DiffWAM流水线图 ©【深蓝AI】编译
1.1 问题定义与输入输出
输入为单张初始RGB图像与自然语言指令,模型输出未来5秒时长的相机轨迹,一共39个相机位姿(包含初始基准位姿),输出每一条位姿包含旋转矩阵与三维平移向量,全部坐标系对齐初始相机帧。
简单理解:输出的是一串时间有序的相机位姿参考序列,不是直接给电机控制指令。输出结果还需要交给下游规划器做动力学可行性校验、时间插值,再下发给飞控,模型本身不做避障、动力学约束保证。
1.2 Grid‑Motion:保留时空关联的特征聚合
直接对视频隐特征做全局池化会破坏空间位置与时间的对应关系,Grid‑Motion做两件关键处理。 第一,时序关联:在特征网格内部,跨时间索引抓取前后时刻特征,计算特征差异,捕捉物体、相机的运动变化; 第二,几何条件关联:把首帧MoGe2输出的几何信息作为value,和预测特征做交叉注意力匹配,把尺度、空间约束注入特征流。 两路信息通过可学习门控残差融合,之后经过记忆池化,输出运动记忆token,送入后续解码器。整个过程不写复杂手工轨迹模板,所有运动关联关系依靠数据学习得到。
1.3 Latent2Pose:几何锚定的位姿解码器
Latent2Pose负责把运动记忆token转换成带度量尺度的相机位姿。 MoGe2输出首帧几何网格,从中计算出场景尺度因子,用来缩放平移输出,解决单目几何尺度模糊问题;解码器内部包含一组预先定义好时间偏移的位姿query,通过多层transformer解码器交叉注意力读取运动记忆与几何token,最后分别输出平移量、六维旋转表示,再通过格拉姆‑施密特正交化还原合法旋转矩阵。
这里尺度因子来自第一张观测图像,后续全部轨迹都复用该尺度,并不是绝对完美的尺度等价,会存在单目估计带来的尺度噪声。
1.4 几何引导预测蒸馏GPD,非对称师生训练
这是整套训练的关键,采用非对称师生范式。
-
学生:只拿到早期截断后的视频隐特征 + 首帧几何,也就是部署阶段的输入;
-
教师:复用同一套视频噪声种子,继续把视频完整推演到底,再用做视频帧重建,搭配MoGe2做尺度校准,得到参考真实轨迹。
学生以教师重建出来的轨迹作为监督信号去训练轨迹读取头;视频主干网络、MoGe2全程冻结,只更新Grid‑Motion、Latent2Pose的参数。 这么做的好处:把完整视频推演、重建这部分昂贵计算全部压到离线训练,线上推理不再运行。损失函数分为位置损失与旋转测地损失两项,不需要重建图像像素。
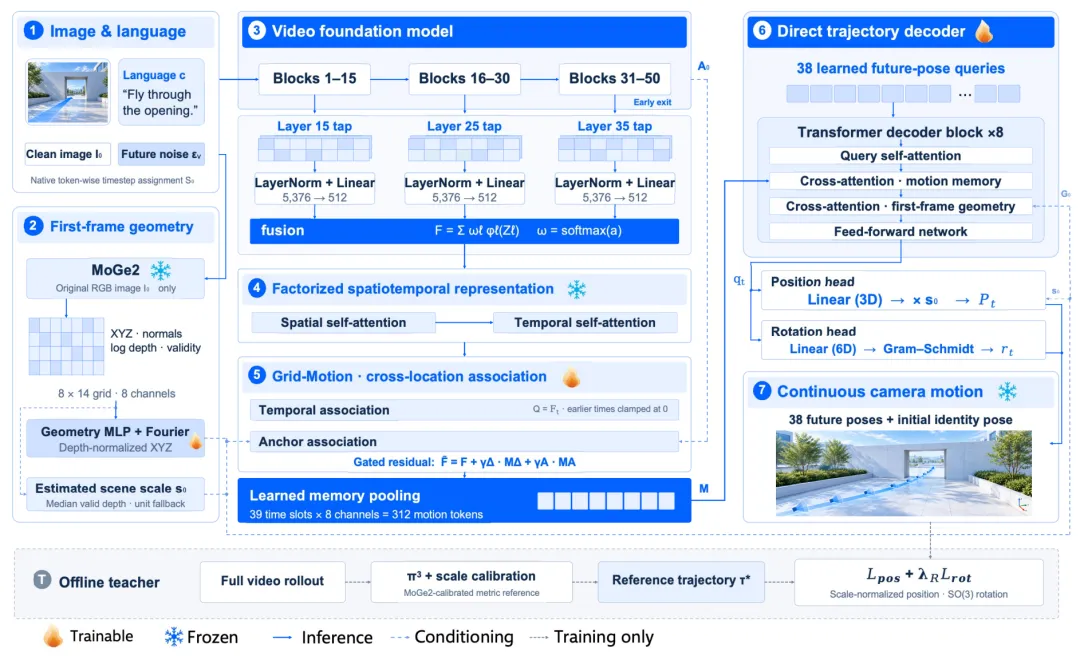
图 | DiffWAM模型架构示意图 ©【深蓝AI】编译
1.5 推理部署逻辑
线上推理时,RGB图像和语言指令送入冻结视频模型,只运行到指定DiT 35模块就提前终止,不再继续扩散迭代,也不执行VAE视频解码;同时并行跑MoGe2获取首帧几何,二者送入训练好的读取头,直接输出相机位姿序列。输出的轨迹是运动提案,必须经过下游规划校验之后才可以发给无人机执行。
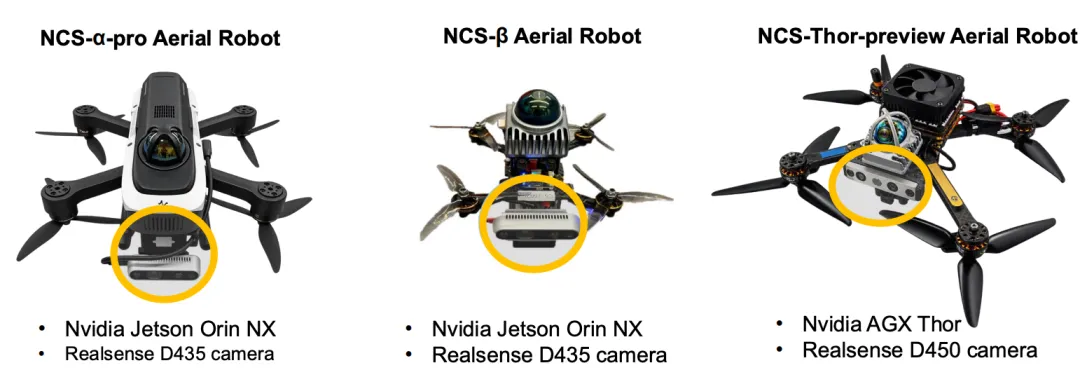
图 | 真实无人机实验平台 ©【深蓝AI】编译
DiffWAM单次输出的只是一段有限时间窗口的轨迹提案,但无人机是持续飞行的。在模型计算新轨迹的这段时间,飞行器本身还在不停运动,等推理完成之后,观测对应的机体状态已经发生偏移,新生成轨迹和现实机身状态对不上,这是大模型机载部署非常现实的工程痛点。FastDreamer就是用来解决这个“计算时延‑机体运动状态失配”问题。
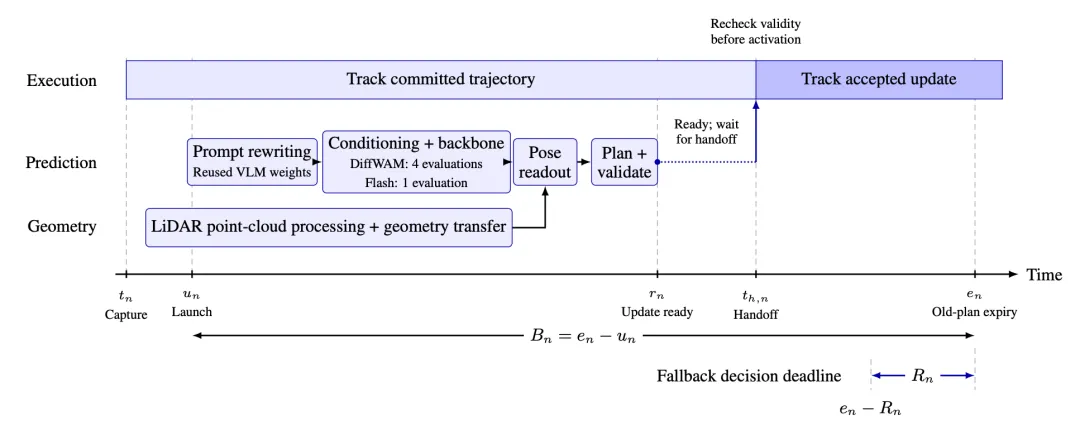
图 | 异步轨迹生成与计划切换时序示意图©【深蓝AI】编译
2.1 权重共享提示改写 + 并行提案推理
长任务的高层自然语言指令,不能直接喂给视频模型,需要根据当前观测、已完成任务阶段,改写成本地子任务提示。为了不额外增加大模型内存开销,提示改写模块复用视频世界模型原本的VLM权重,不需要额外加载独立大模型。
提示改写与MoGe2几何估计可以并行运行,互不依赖,压缩整体推理关键路径耗时。DiffWAM‑Flash只执行一次视频主干评估,进一步压缩延迟,代价是精度有所下降。
2.2 飞行时间预算计算
系统为每一轮新轨迹提案分配飞行时间预算,也就是当前正在执行的旧轨迹剩余时长。会把提示改写、特征推理、规划校验、通信全部纳入耗时预估,同时预留回退保护余量。
如果预估总开销超过剩余飞行预算,该次生成就不能在计划切换时刻就绪,要么等待下一轮窗口,要么直接放弃本次提案,继续沿用旧轨迹或者触发保护悬停。不会无限阻塞等待模型输出,避免无人机失控。
2.3 带时间戳的预期切换机制
每一份生成出来的轨迹提案会绑定它对应的图像捕获时间戳,而不是推理完成时间。规划器预测到预定未来切换时刻的机体状态,做轨迹过渡拼接,保证位置、速度连续性。
一个容易被忽略点:不会直接删掉提案前面一段轨迹简单对齐时间差。必须结合任务语义判断哪些动作已经物理执行完毕;对于绕圈、穿行这类有顺序要求的任务,不能粗暴截断轨迹,否则会破坏指令要求的运动逻辑。如果找不到满足条件的平滑过渡,就直接拒绝这份提案。
3.1 数据集与评测基准
训练数据来自FlyMirage、NavGen两套合成管线,合计超过510K训练片段,覆盖基础运动、物体导航、特定形状轨迹等各类无人机行为。 评测使用自建DiffWAM‑1000基准,一共1000条测试样本,分为四大任务家族。
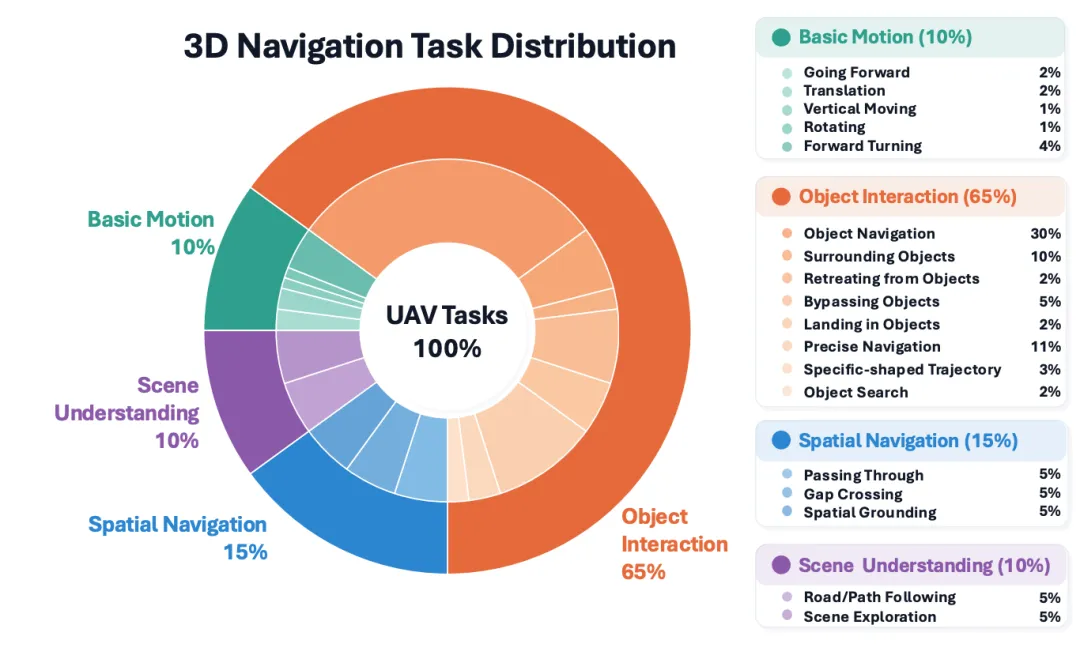
图 | 3D导航任务分布饼图:评测基准包含四大任务家族:基础运动10%、物体交互65%、空间导航15%、场景理解10%,合计18种子任务 ©【深蓝AI】编译
评测指标分为:端点FDE误差、整条轨迹RMSE/ADE、姿态RoE角度误差;仿真与真机额外统计闭环任务成功率SR。
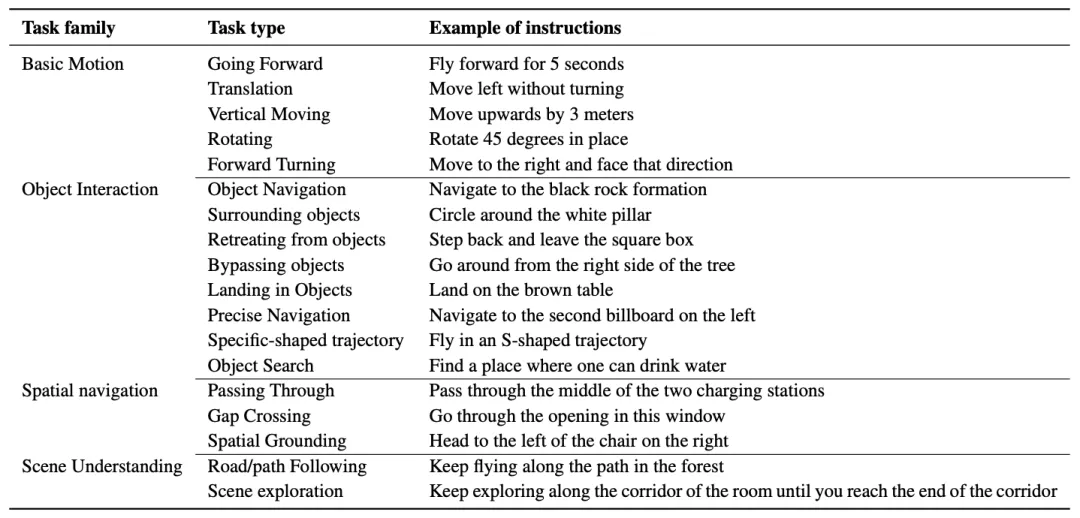
表 | 评测基准任务构成表 ©【深蓝AI】编译
指标客观局限:端点成功率只看终点是否靠近目标,完全无法评判中间过程是否符合指令。例如指令要求绕物体一圈,模型可以直接飞到终点,但是完全没有完成环绕动作,端点指标依然判定成功。因此必须结合定性轨迹可视化一起评估,不能单看表格数字。
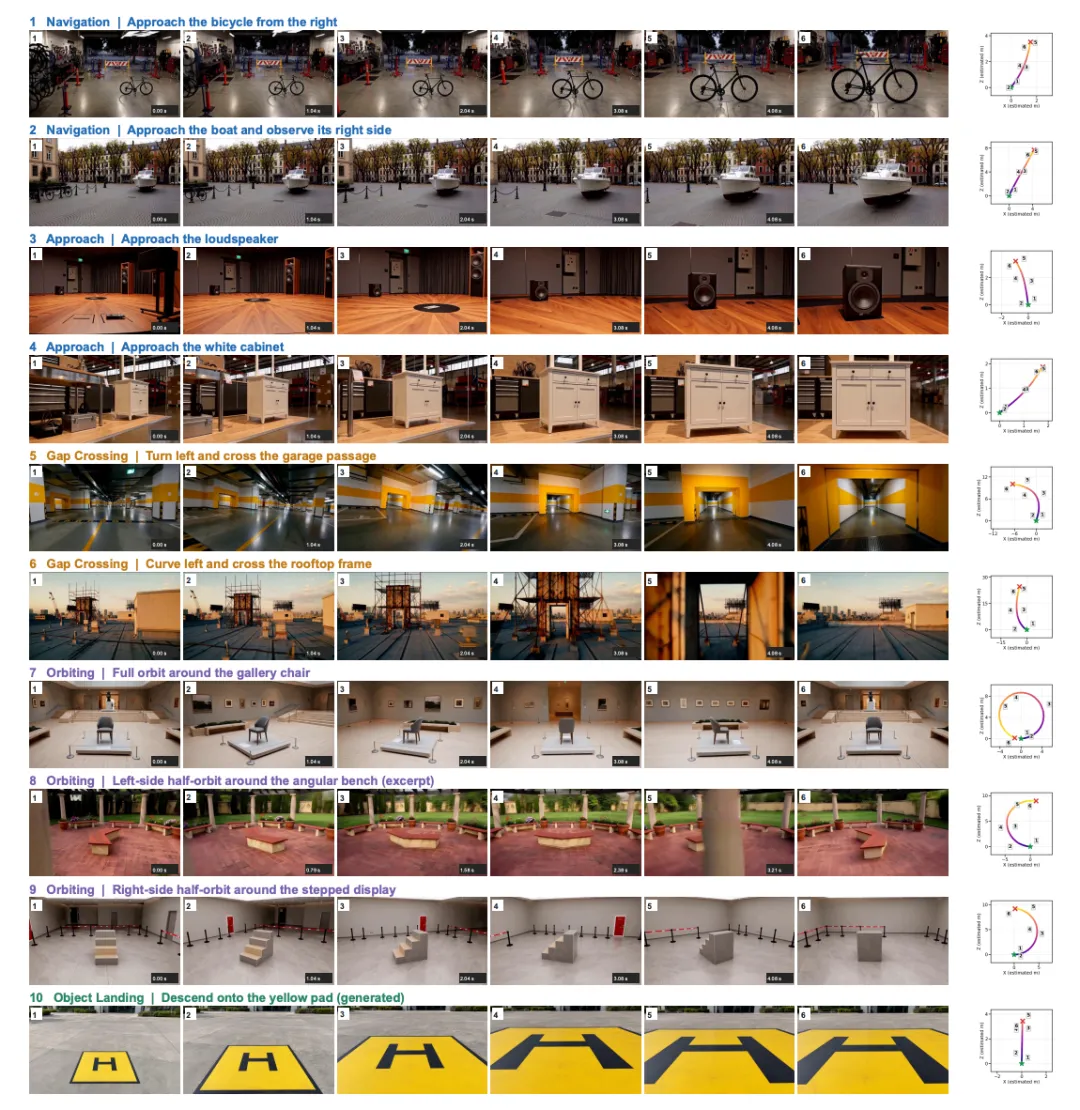
图 | DiffWAM代表性轨迹生成结果 ©【深蓝AI】编译
3.2 横向基准对比
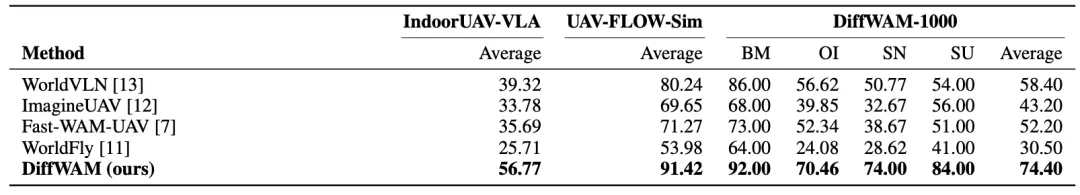
表 | IndoorUAV‑VLA、UAV‑FLOW‑Sim、DiffWAM‑1000基准任务成功率(%) ©【深蓝AI】编译
DiffWAM在三套数据集端点指标全部最优,尤其在空间导航、场景理解类任务提升幅度最大。但再次强调,该表格只是端点统计,不能代表中间轨迹形态全部满足语言指令。
3.3 机载延迟性能
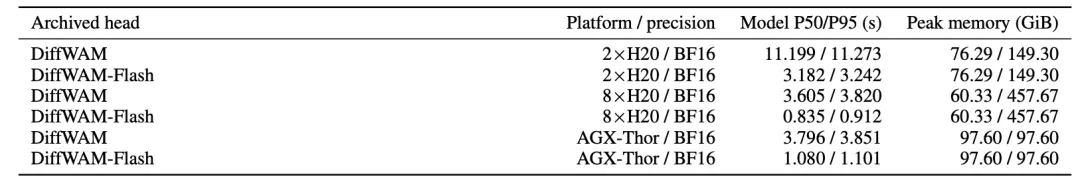
表 | FastDreamer归档流水线各硬件平台延迟测量结果,全部BF16推理 ©【深蓝AI】编译
对比NavDreamer必须完整跑视频生成,动辄8‑10秒级别耗时,DiffWAM把大量视频生成计算直接砍掉。DiffWAM‑Flash在AGX Thor板子1.08s模型流水线延迟,但要注意:这个时间不含提示改写、外部通信、下游规划校验,完整闭环更新延迟会更高,还达不到毫秒级高频控制,更适合中速更新的高层导航规划,不是用来替代底层飞控。
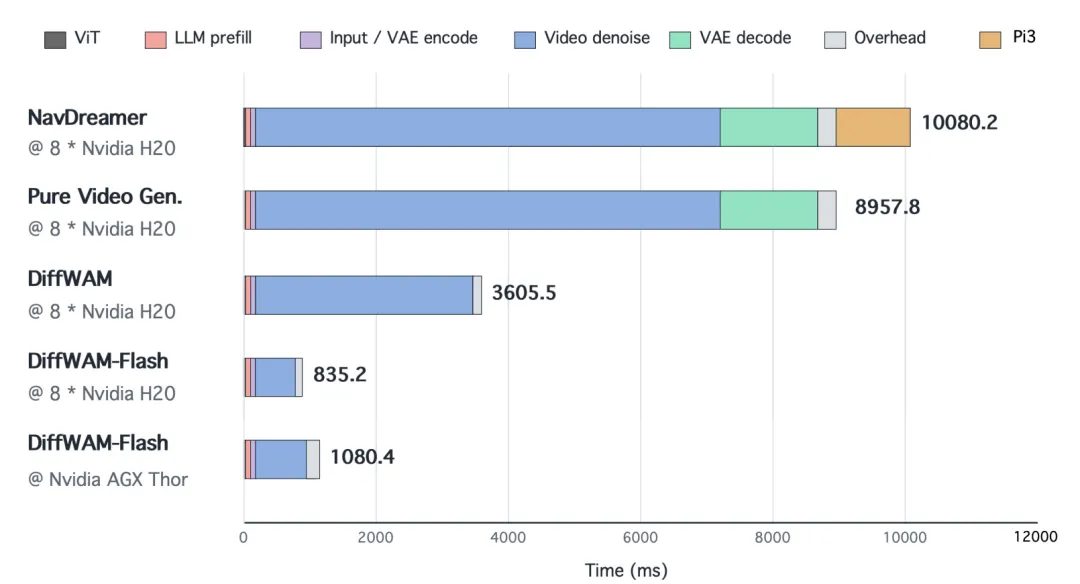
图 | 各推理流水线分阶段耗时拆解柱状图 ©【深蓝AI】编译
3.4 关键消融实验
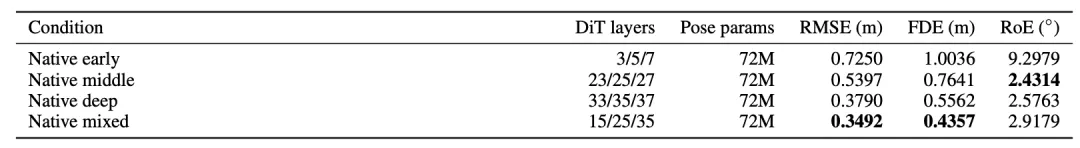
表 | 视频模型特征层选择消融实验 ©【深蓝AI】编译
混合15/25/35层组合位置RMSE取得最优0.3492 m;只取浅层或者只取深层特征效果都会下降;姿态误差最优并不是该组合,说明位置、姿态信息在网络不同深度分布不一样,多层融合是收益来源。
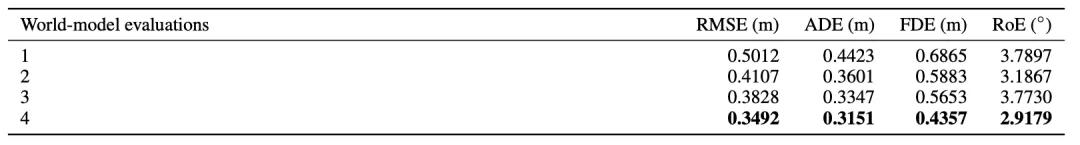
表 | 预测计算轮次消融实验 ©【深蓝AI】编译
1次对应Flash版本,4次为标准版DiffWAM。随着评估轮次增加,位置误差持续下降,但推理延迟上升。工程上可以根据算力做精度‑速度权衡。
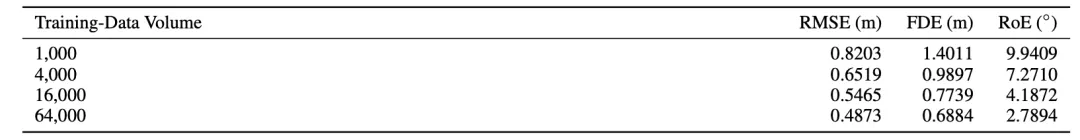
表 | 监督训练数据规模消融实验 ©【深蓝AI】编译
在固定训练迭代数下,轨迹配对样本越多,位置、姿态误差越低,性能随监督样本规模提升而饱和。
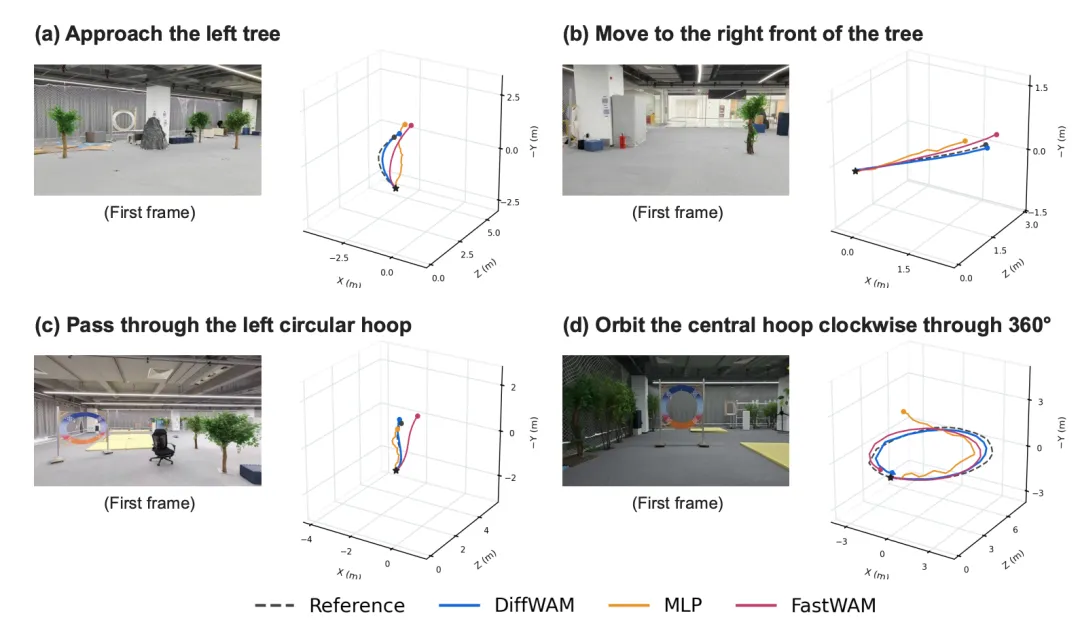
图 | 不同WAM读取头架构定性轨迹对比图,包含参考真值、DiffWAM、MLP基线、Fast‑WAM ©【深蓝AI】编译
简单MLP基线读取头很容易出现轨迹畸变,尤其环绕任务,哪怕终点接近,中间路径完全不符合要求,体现Grid‑Motion+Latent2Pose这套结构化读取头的价值。
DiffWAM跳出“生成完整未来视频再提取运动”的固有范式,依靠截断视频预测特征、Grid‑Motion时空特征聚合、Latent2Pose几何锚定、非对称蒸馏训练,实现从视频中间表征直接输出无人机连续导航轨迹;搭配FastDreamer异步执行框架,解决无人机边飞边计算带来的状态时序失配,完成仿真、多组室内外真机的验证。
它没有解决底层高频飞控问题,面向的是语言指令驱动的高层导航规划。该工作给视频世界模型机载部署提供一条新思路:不一定非要把图像全部生成出来,我们只需要从海量视觉先验里面,提取机器人真正需要的运动信息即可。当然,视频基座幻觉、单目尺度不确定性、真实野外大规模鲁棒性,依旧是这条路线绕不开的现实挑战。
值得一提的是,高飞老师也是第四届自主机器人技术研讨会(ARTS 2026)的参与嘉宾。
本届大会将于10月30-31日在北京盛大举办,汇聚榜单级学者与40余位青年领域专家,带来一场沉浸式的深度讨论。是观众,亦是同行者。
期待在北京与您相遇,在思想的碰撞中共同推动自主机器人技术的未来。
了解线下会议详情⬇️
编辑|小小怪博士
审核|阿蓝
Ref
参考论文:DiffWAM: A Fast and Efficient Navigation World Action Model
论文链接:https://arxiv.org/pdf/2609.39763
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇