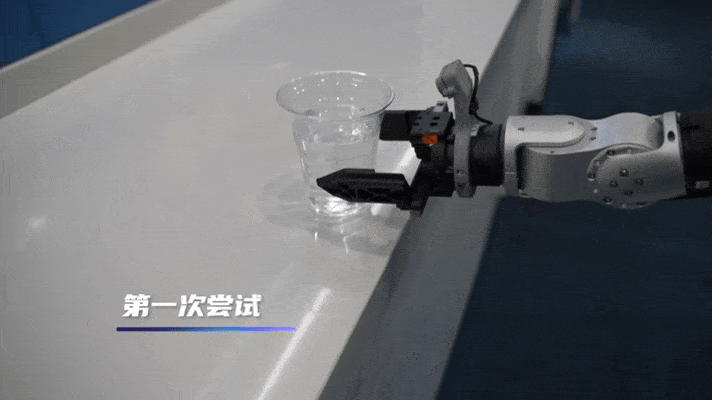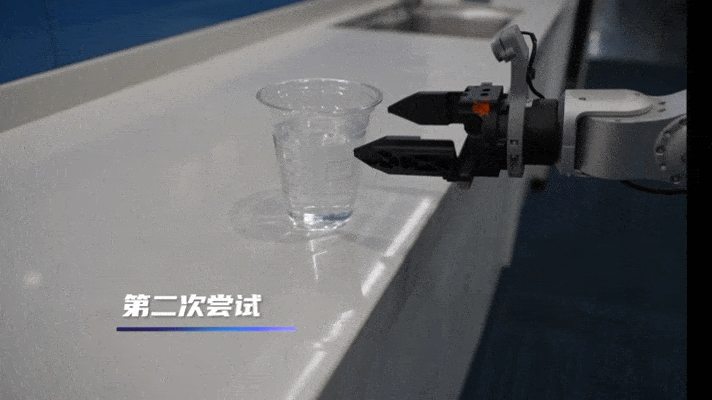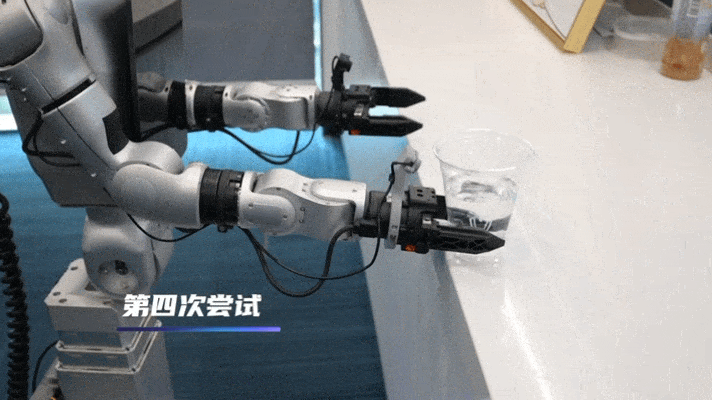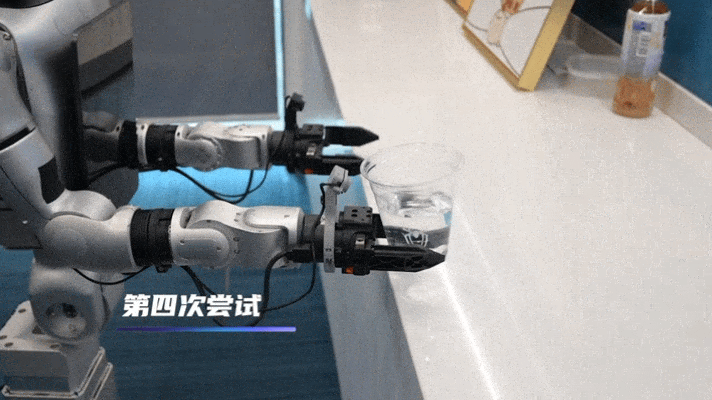
预训练是能力的起点,部署才是进化的起点。
——模型冻结,能力外挂
当同一个 VLA 换个厂房、换个光照、换个摩擦系数就开始掉点时,一般的默认解法是“回炉”——重新采集、标注、微调、再部署,一个场景一套。
清华智能产业研究院(AIR)与 Z-Trans AI 给的是另一种解题思路:∇θ = 0,一行权重都不改。
把“让机器人变强”这件事从模型里面挪到模型外面。
三个月,三层堆栈,一个主张
这不是一次孤立的成果发布,而是把“记忆—Agent—模型”三层在约三个月内补齐的一条完整路线。
按时间排下来,三篇研究各占一层:
-
MemCompiler在最里面管记忆怎么用;
-
Zetta ζ在中间管执行期的护栏与技能库;
-
Zeva在最外面管冻结策略的输入。
三者共用一条硬约束:部署期不允许任何权重更新。
他们关心的一直不是“把模型训得更大”,而是算法—系统—硬件协同怎么把闭环塞进真实约束里——
当年是塞进 Office 与 Windows 的内存和功耗,如今是塞进机器人的摩擦、延迟与认证成本。
MemCompiler:别再把记忆一次性灌进去
把"开局整块注入"改成"按当前状态现用现编译"。
研究方法
现有具身记忆系统的主流做法,研究称之为 AMMI(Ahead-of-time Monolithic Memory Injection)——在 episode 开始时把检索到的整块记忆当成静态上下文塞进 prompt,之后不再变。
问题是这套静态设计和智能体不断变化的执行状态很快错配,论文指出它可能把轻量 executor 拖到比"无记忆基线"还差的位置。
MemCompiler 把它重定义为状态条件记忆编译(SCMC):
一个学出来的 Memory Compiler 读取结构化的 Brief State(当前观测加已完成子目标的摘要),动态挑选并"编译"出这一步真正用得上的记忆,再通过一条文本通道和一条保留感知信息的 Soft-Mem 潜在通道交给 executor。
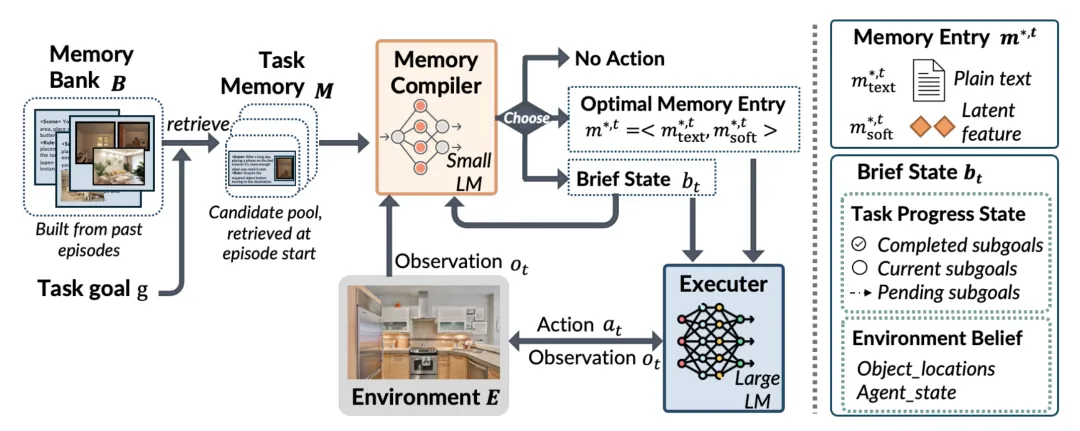
▲图 | MemCompiler 运行时第 t 步的工作流程与模块交互图©【深蓝具身智能】编译
论文创新点
-
记忆从"资产"变成"编译产物"
不再一次性投放,而是每一步根据运行时状态重新筛选与组装,从根子上避免"记忆越长越干扰"的问题。
-
双通道下发
文本通道管可符号化的经验,Soft-Mem 潜在通道补上文字说不出来的知觉信息;可视化显示两类 token 在表示空间占据互不重叠的区域。
在 AlfWorld、EmbodiedBench、ScienceWorld 三套环境与多种开源骨架上一致超过无记忆基线,最高 +129%;效率侧同样改善,减少单步延迟 60%。
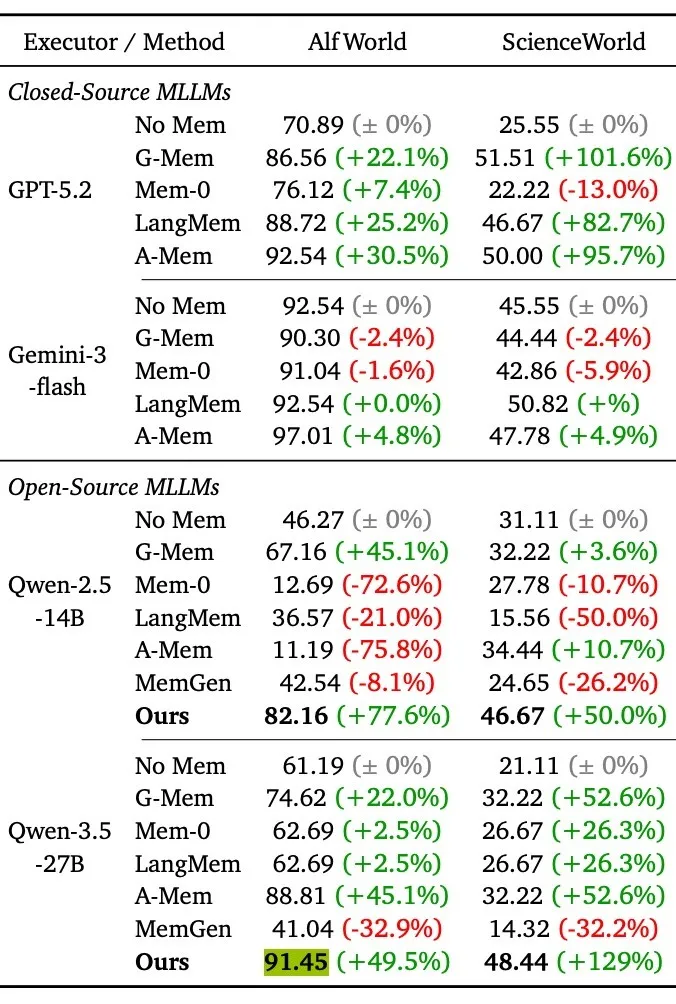
▲表 | MemCompiler 在 AlfWorld 与 ScienceWorld 上的成功率对比©【深蓝具身智能】编译
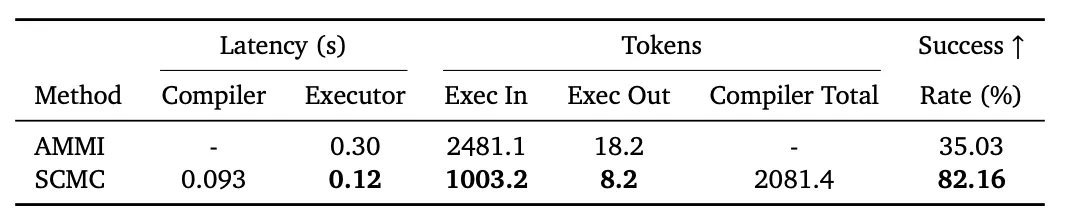
▲表 | AlfWorld 上的效率对比©【深蓝具身智能】编译
三套评测环境全是文本或离散动作环境;最大的 +129% 出现在 ScienceWorld 配 Qwen-3.5-27B 这一组,换组合数字就变;Soft-Mem 是学出来的潜在 token,行为出错时基本无从归因。
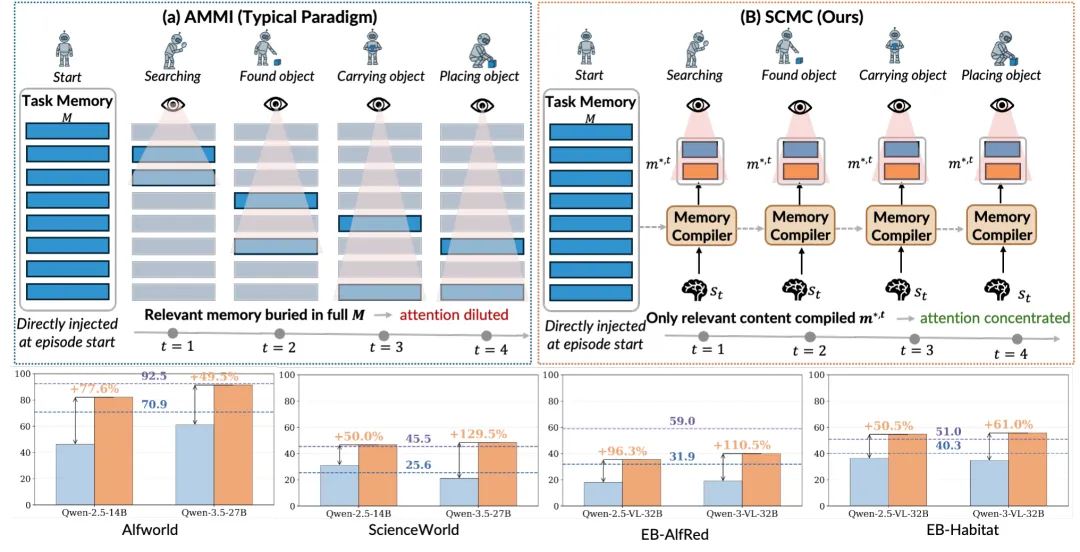
▲图 | 两种记忆使用范式对比:AMMI 在开局注入全部任务记忆,MemCompiler 按当前状态按需编译 ©【深蓝具身智能】编译
Zetta ζ:把"反思"从大模型身上摘下来
让代码化的 critic 在动作频率上盯着执行。
研究方法
Zetta 把可演化的对象定义为 harness H = {C, R, T}:
运行时 Critic C(在动作频率上扫描、由代码写成的监控函数)、恢复手册 R(失败机制到可执行策略的映射)、异构工具集 T(规划器、抓取检测、恢复模块)。
关键设计是把“反思”从 LLM 身上剥离:物理状态毫秒级变化,大模型够不着这个频率,所以在线判定交给代码,LLM 只做低频裁决与离线进化。
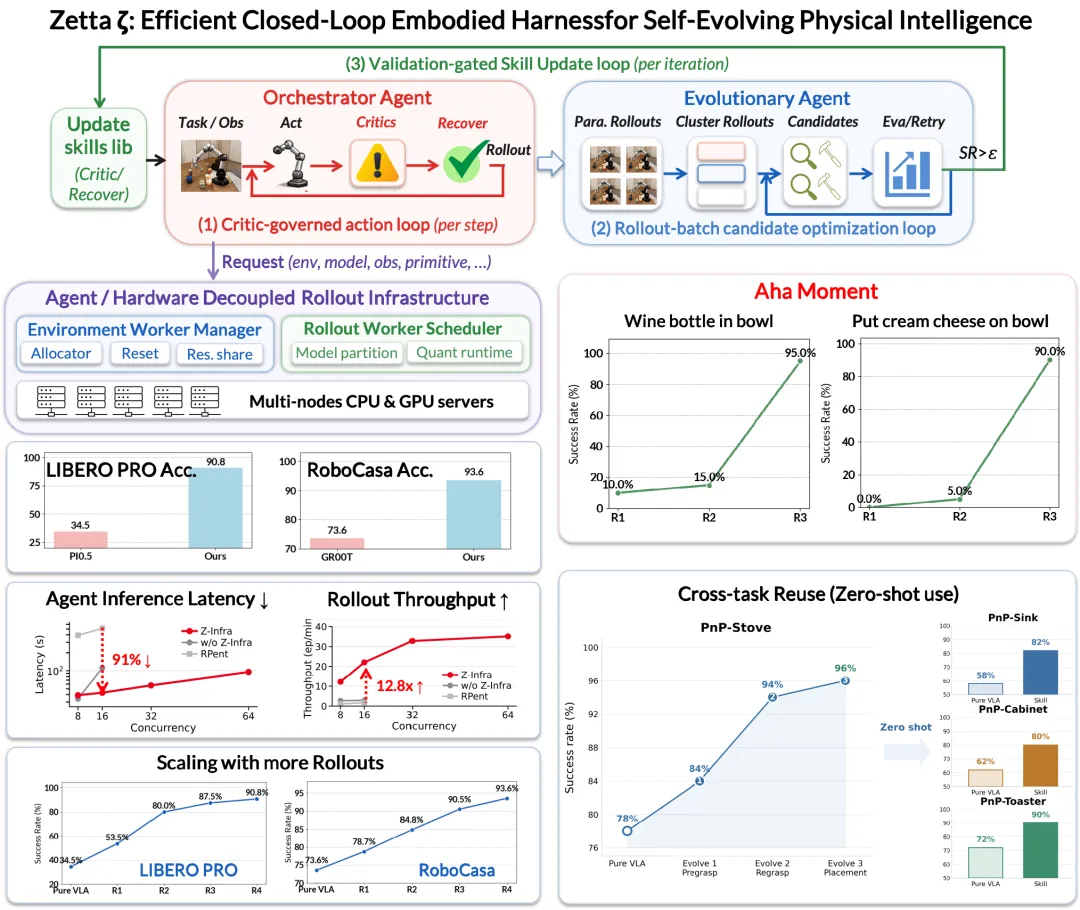
▲图 | Zetta 的具身自进化闭环:运行时 critic 在动作频率上触发恢复,被验证过的失败蒸馏成可复用技能©【深蓝具身智能】编译
三条时间尺度分层:动作级触发恢复;批量级按最早可观测发散点(EOD)而非最终结果聚类失败,再沿"评估→Critic→状态→规划→恢复→参数"自上而下诊断,坚持高层逻辑能修就不动低层参数,并用历史回归加严格 held-out 验证做迭代门控;
另有一道 VLA 重入契约,只有失败证据被显式清除且接触力达到平衡,控制权才交还基座。
自进化的速度由 rollout 决定,配套的 Z-Infra 对 π0.5 做模型分区(VLM 与动作专家拆成独立进程、CUDA IPC 传中间激活),再按模块上 W8A8 / W4A16 / W4A8 量化。

▲图 | Zetta 进化框架总览:在线执行与离线进化之间构成持续闭环©【深蓝具身智能】编译
论文创新点
-
把 harness 提升为一等公民
它与基座模型解耦、可版本化、可审计,等于在不触碰已认证权重的前提下给机器人留出了一条能力增长通道。
-
EOD 聚类 + 自上而下诊断 + held-out 门控
失败不看结局看最早分歧点,修复先逻辑后参数,上线前必须过留出集回归,把"自进化"做成有闸门而非无约束的工程流程。
实验数据显示,LIBERO-Pro 上 π0.5 的 Goal-T 由 31.0% 升至 92.5%、Goal-S 由 38.0% 升至 89.0%,Goal 平均 34.5%→90.8%;
RoboCasa 上 GR00T N1.5 经四轮累积修复由 73.56% 依次走到 78.71%、84.85%、90.54%、93.56%;
工程侧 Z-Infra 平均推理延迟降 53%、200 ms SLO 内 goodput 提升 2.4 倍、量化再得 1.18–1.32 倍,吞吐 1.7→35.1 集/分钟(20.6 倍)。
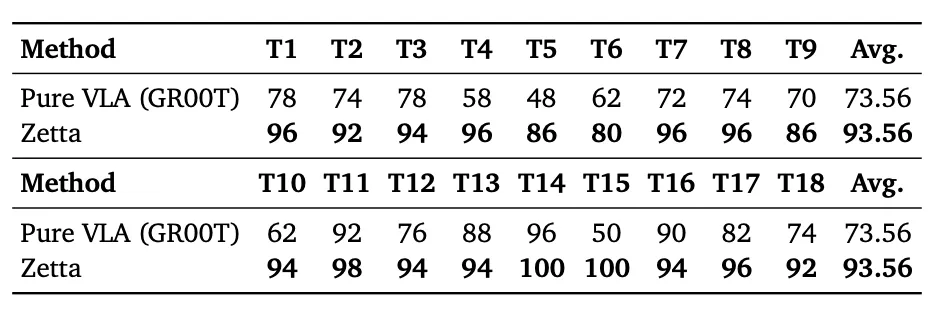
▲表 | Zetta 与基线方法在 18 项 RoboCasa Atomic-Seen 任务上的成功率对比(%)©【深蓝具身智能】编译
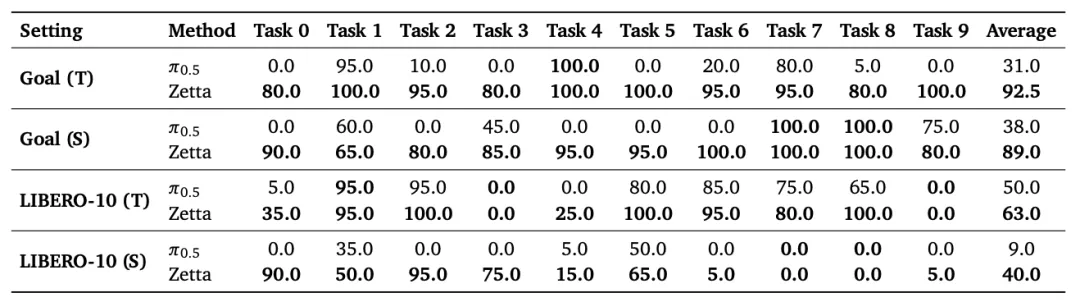
▲表 | Zetta 与基线方法在 LIBERO-Pro 基准测试上的成功率对比(%) ©【深蓝具身智能】编译
但是,harness 只能把 VLA 拉回它熟悉的分布,基座压根不会的任务补不上来(LIBERO-10 的 S 扰动停在 40.0% 就是这个原因);critic 与 recovery 由 LLM 生成,论文专门用"单视角锚定 + 仿真器内部状态交叉验证"压制空间推理幻觉,这本身就说明自动化程度有限。
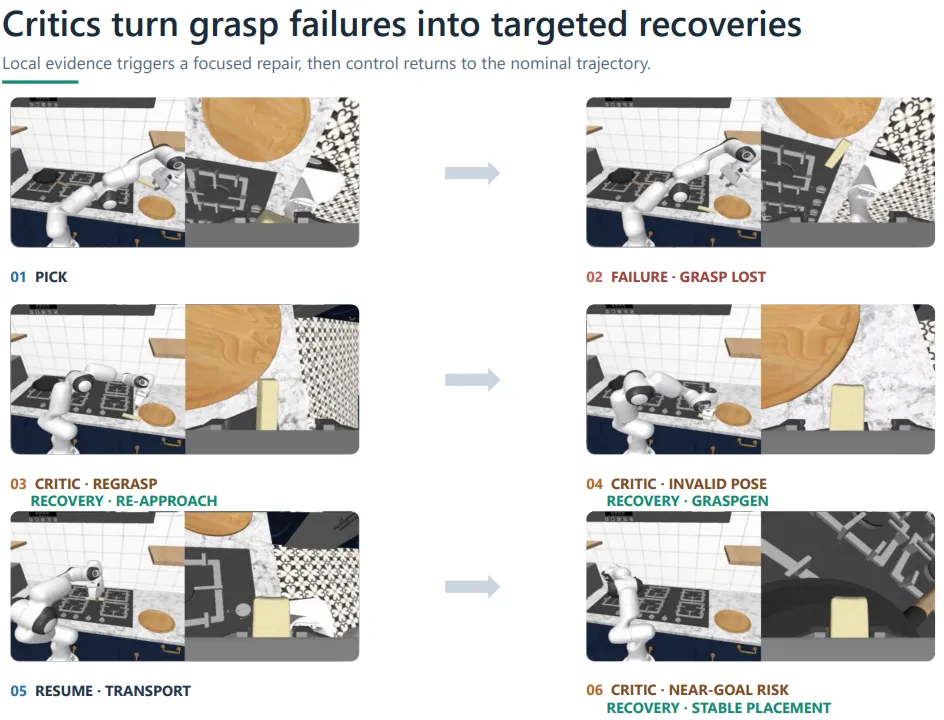
▲图 | 一次抓取—运输—放置过程中的 critic–recovery 干预序列:检测到抓握丢失后触发重新接近与重抓,稳定后才交还控制权(来源:原论文 Figure 12)©【深蓝具身智能】编译
Zeva:从自己的失败里提炼因果,再喂回冻结的策略
不动权重、也不依赖人类示范。
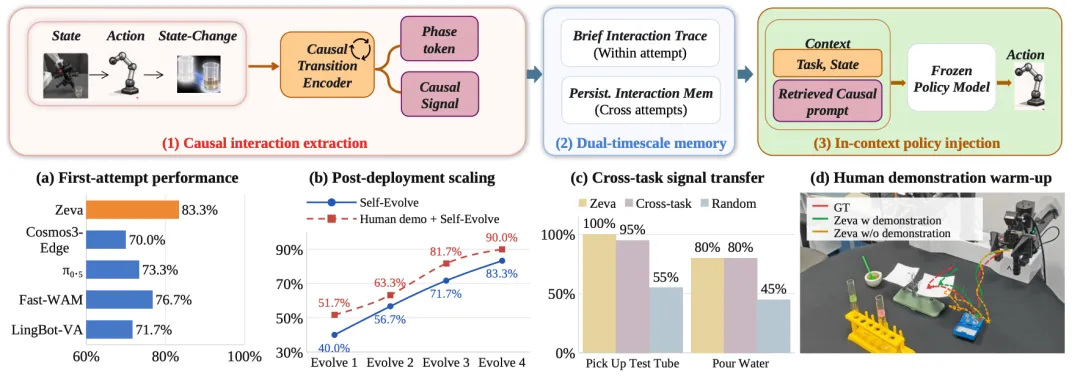
▲图 | Zeva:通过因果学习实现自进化的具身智能架构与评估©【深蓝具身智能】编译
研究方法
Zeva 的地基是上下文因果学习(ICCL),先厘清它和两条易混路线的区别:
-
RoboTTT、WAM-TTT 这类 test-time training 靠部署时的梯度更新权重;
-
GEN-1.5、Skild S1 这类上下文学习权重不动但依赖人类示范。
Zeva 走的是第三条:从自己的交互轨迹里提取动作与状态变化的因果再喂回自己。
工程上分三段:
-
CTE(因果迁移编码器)把视觉状态、动作编码与观察到的效果压成"因果交互状态",并拆出任务阶段 token 与因果交互信号;
-
接着是双时标记忆,BIT 负责当前这次尝试的近期动态,PIM 在同一 episode 的多次尝试间按相似度合并巩固——刻意分层是为了不让一次偶发失败污染长期记忆;
-
最后 In-Context Policy Injection 按任务阶段检索证据、拼成 Causal Prompt 注入冻结策略。部署期所有模型参数冻结,只有交互缓存在线更新。
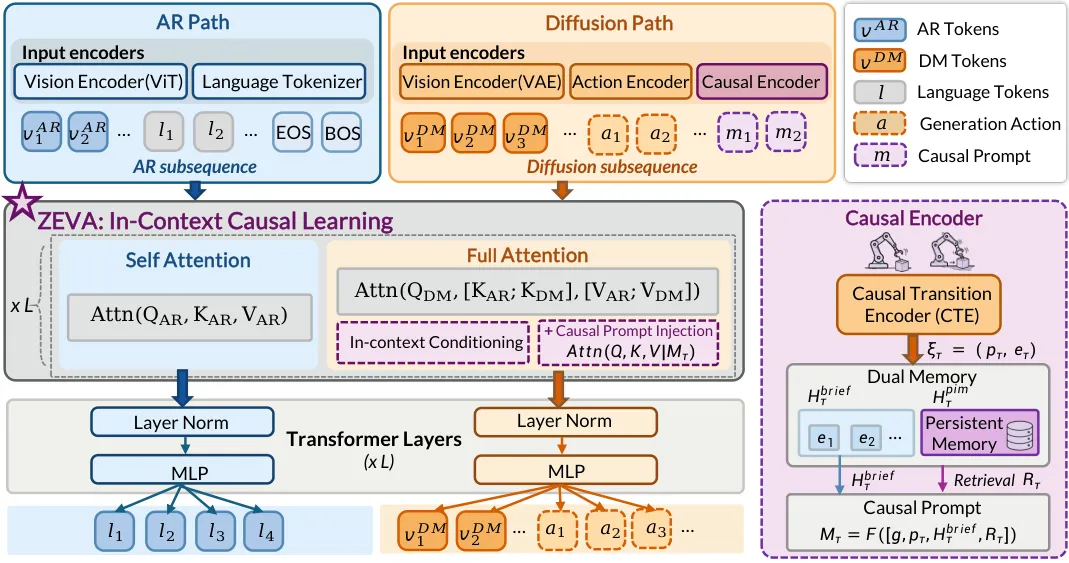
▲图 | Zeva 框架架构:CTE 提取因果交互信号,经双时标记忆沉淀后按阶段检索并注入冻结策略©【深蓝具身智能】编译
论文创新点
-
第三条路线:经验来自自身而非人类
既不动参数,也不要求每个任务都配一段人类示范,把"从交互中学"这件事真正落到了无标注的自我经验上。
-
双时标记忆与 PIM 合并巩固
近期动态与跨尝试证据分开存放,既保留了对最新失败的敏感性,又避免了上下文无限膨胀。
实验数据显示,RoboCasa365-Atomic5 五任务均值 76.8%(LingBot-VA 55.2、Xiaomi-Robotics-1 31.2、τ0-WM 29.0、Cosmos3-Nano 64.8、Fast-WAM 72.4);
同一批任务上重复尝试带来的 scaling 为 26%→73%;真机化学实验场景 ChemLab-Evo(ARX 机械臂)Level-1 三任务均值 83.3%(π0.5 73.3、Cosmos3-Nano 70.0、Fast-WAM 76.7、LingBot-VA 71.7),其中取试管 100%、放烧杯 70%、倒水 80%;去掉 BIT 与 PIM 后这三项掉到 65%、40%、45%。
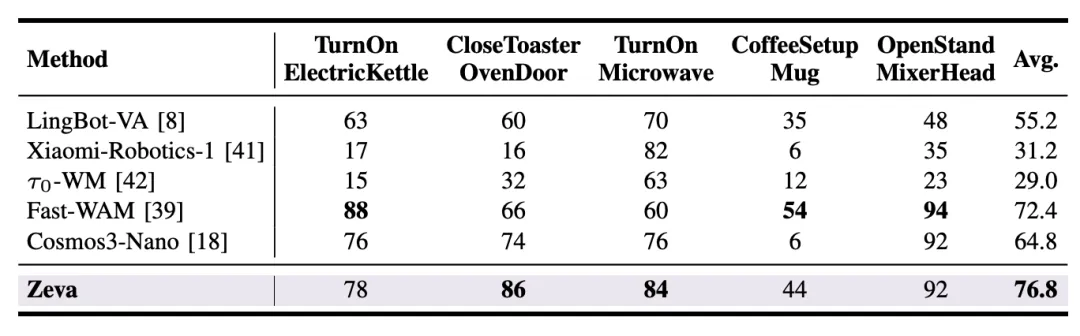
▲图 | RoboCasa365-Atomic5 上各方法的任务成功率©【深蓝具身智能】编译。
如果不允许改权重,机器人还能不能变强?
这三篇串起来回答的便是这一问题。
先看它在赛道里的坐标。所谓"部署期适应"这件事,事实上至少有四条并行的路线,区别只在于"改什么"。
真正的新意在于把变强发生的位置从参数挪到了外层的记忆与 harness,并且把它做成了有门禁的工程闭环:失败要聚类、定位要靠代码化的 critic、修复自上而下、上线要过 held-out 回归。
这就不是换个姿势做 prompt 工程,它有一条闭合的证据链。
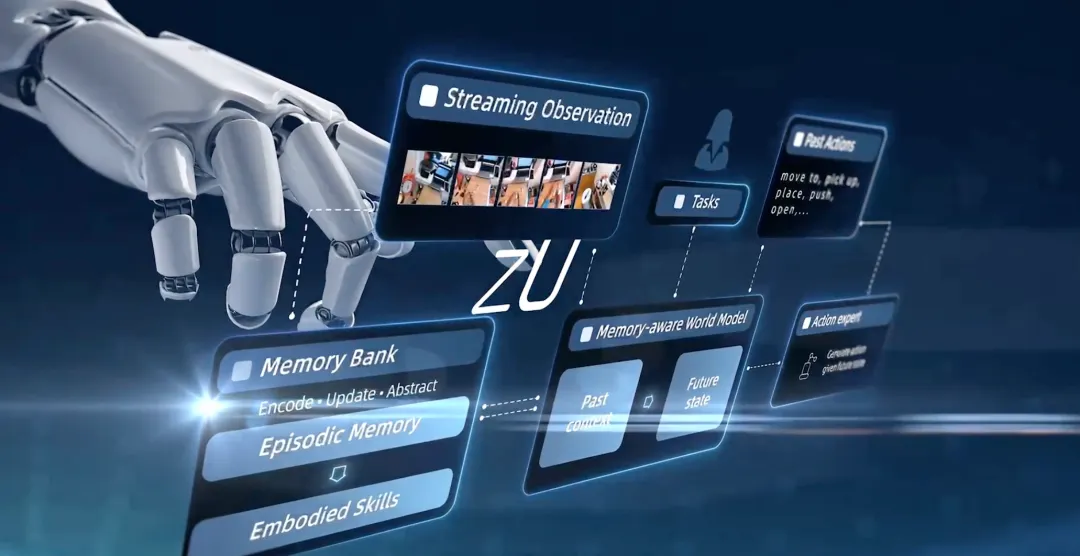
更值得关注的还有它的合规价值:工业现场改动一个已认证模型要重做整套验证,把可变部分放在外挂护栏与上下文里,审批负担小得多;它也不排斥继续堆预训练,是互补而非替代。
反过来,四条边界绕不开:结论几乎全部来自仿真;基座冻结就是天花板;harness 随轮次膨胀;held-out 即便严谨,也仍是同一实验室的划分。
说白了,这条路线的赌注是:机器人的竞争力不再由出厂那一刻决定,而由部署之后拿到的 rollout 数量决定。
编辑|小小怪博士
审编|具身君
Ref
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇