机器人怎么从真实店员身上学操作?
——从“看见”到“量出”
相比让机器人通过遥操作从头采集演示,能否直接记录人类熟练操作,再将其用于机器人学习?
这些动作每天都在真实发生,熟练、稳定、有明确目的,正是机器人学习最想要的那种数据。
麻烦在于,它们从来没有被"测量"过。相机记下的是画面,模型要的是动作:手腕在三维空间里移动了多少厘米,手指关节弯了几度,哪些运动来自双手,哪些只是拍摄者低头或转身。
9 月,觅蜂科技(Maniformer)联合西北工业大学、西安交通大学等机构提出的 MEgoVista,研究的就是如何跨过视频与三维动作之间的这一步。
它把自然场景下的第一人称记录,转换成具有真实物理尺度、可以连续追踪的双手和头部运动轨迹。
视频越来越多,为什么可用的动作数据仍然稀缺?
第一人称视频(Egocentric Video)为具身智能带来了另一种数据采集方式。一个人戴上相机,就能在餐饮、清洁、维修等真实环境里记录操作过程,不需要每次都配备机器人和遥操作设备。
问题是,视频中的“拿起杯子”是一项视觉观察,训练动作策略则需要更明确的空间信息。
以现有数据为例,ARCTIC、Assembly101 等数据集可以借助动捕和多机位设备获得精细标注,但场景主要局限在受控空间;Ego4D 覆盖了大量日常活动,视频丰富,却不提供对应的米制三维手部运动标签。
采集规模和动作精度之间,始终存在一道门槛。
MEgoVista 选择从采集和重建两端同时入手:
使用配有鱼眼相机与惯性传感器的 MEgo View 头戴设备记录画面,再通过离线算法恢复每一时刻的手部姿态、手腕位置与头部位姿,最后把它们放进同一个具有物理尺度的世界坐标系。
这里的“4D”可以简单理解为:不只知道某一帧手长什么样,还要知道它在一段时间内怎样运动。
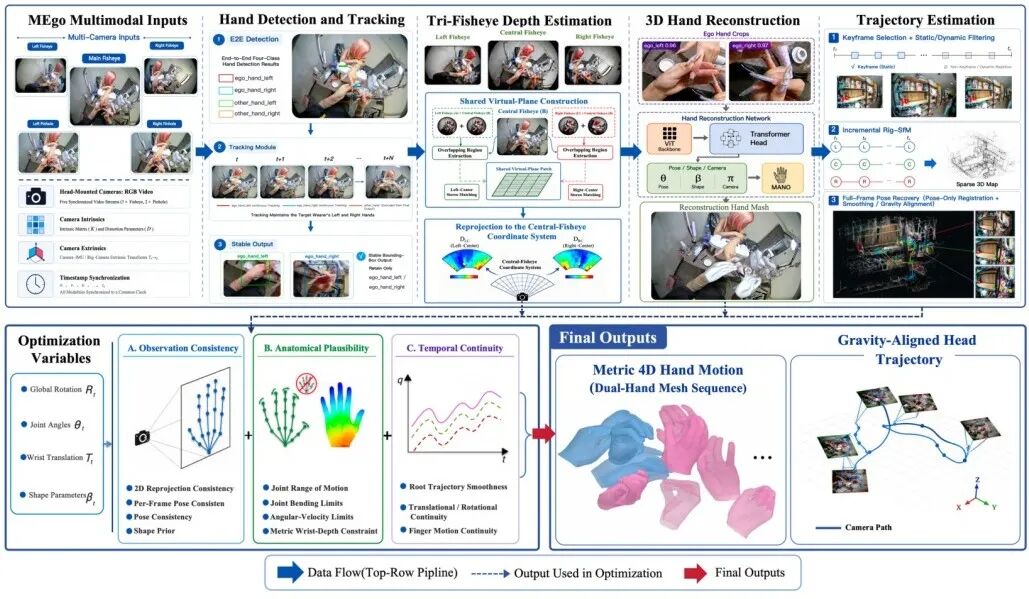
▲图1|从第一人称视频到机器人可利用的动作标签,中间需要跨过身份、深度和时间三道关。MEgoVista 没有把它们压进一次预测,而是先定位正确的手,再利用多视角几何确定空间位置,最后在整段视频上修正轨迹;头部运动则单独恢复,用来建立统一的世界坐标。©【深蓝具身智能】编译
整套系统的关键,不是“把手重建得多精细”,而是保证后续所有计算都发生在正确的手上。
画面里出现多只手,算法该跟踪哪只?
在美甲、按摩或协作装配等场景里,第一人称镜头可能同时拍到操作者和顾客的手。它们经常靠得很近,甚至互相遮挡。
常规手部检测器擅长识别位置和左右手,却未必能判断手的主人是谁。一旦把顾客的手接进操作者的运动轨迹,再精准的三维重建也失去了意义。
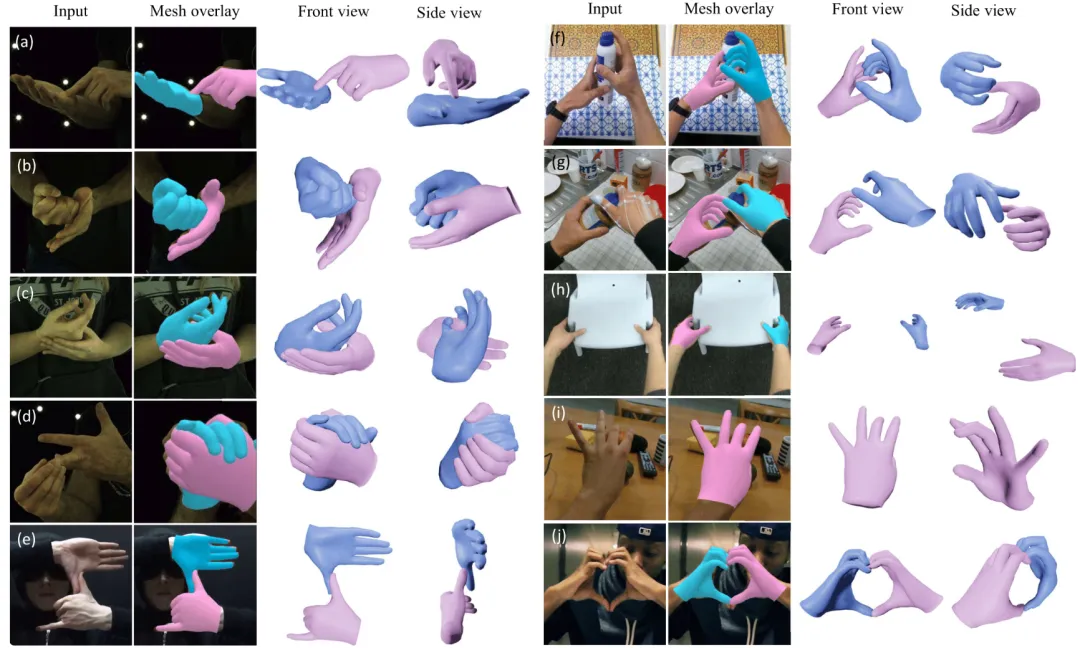
▲图2|当双手交错、接触或短暂遮挡时,难点不只在于恢复每根手指的形状,还在于维持它们前后帧的身份一致性。对第一人称操作数据而言,一次手部归属混淆,就可能把原本连续的动作记录接到另一只手上。©【深蓝具身智能】编译
因此,MEgoVista 从检测阶段就把三件事放在一起判断:手的位置、左右属性,以及是否属于设备佩戴者。
具体做法是一个端到端检测器,直接输出“自我/他人 × 左手/右手”的类别;并通过轻量级跟踪维持身份连续性,输出跨序列一致的手部框。筛选出佩戴者的双手之后,系统才借助 WiLoR、HaMeR 一类回归模型,生成逐帧的 MANO 手部初始姿态。
MANO 是一种参数化三维手模型,可以用少量参数描述手掌形状和各关节弯曲。
它让“看到一只手”进一步变成“得到一副三维手骨架”。不过,这还解决不了另一个对机器人尤其重要的问题:这只手究竟位于空间中的什么位置?
从“看起来像”到“量得出来”,差了一段真实距离
单张图像可以估计手的姿态,却很难准确确定深度。手在画面里变大,可能是向相机伸近,也可能是视角发生变化。
单目深度模型能够根据训练经验给出距离估计,但对于机器人动作监督,手腕前移 5 厘米还是 15 厘米,是两条截然不同的运动轨迹。
MEgoVista 的做法是给第一人称相机加入一把真正的“尺子”:
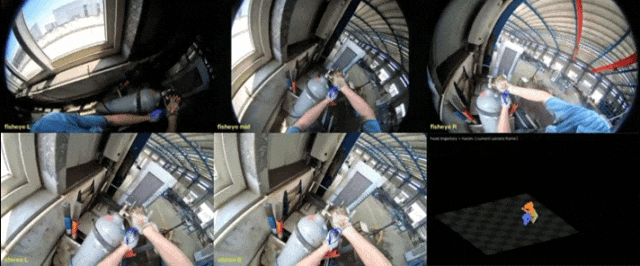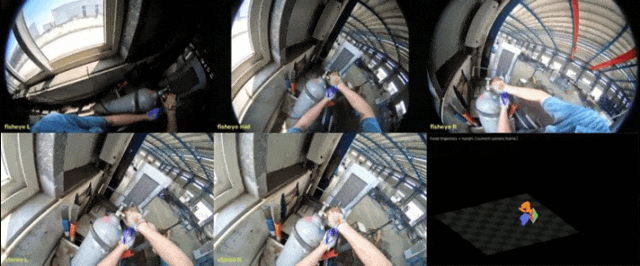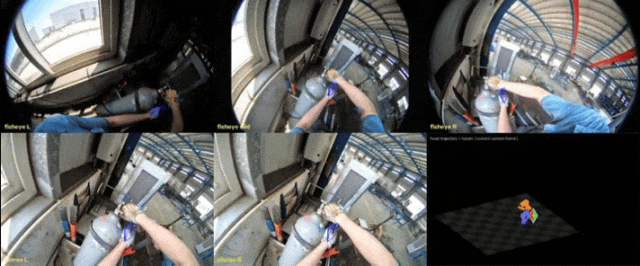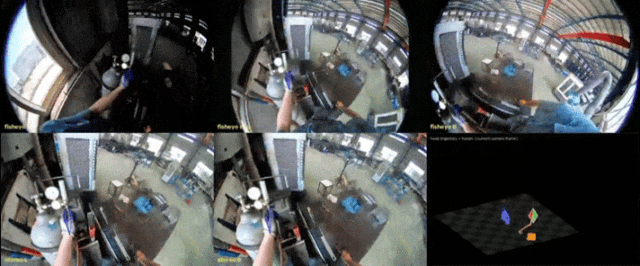
MEgo 本体集成 5 路相机,通过多方向、多视角协同采集实现超大 FOV 覆盖,为手部、场景结构及相机运动恢复提供丰富的视觉信息。
其中,三路鱼眼相机之间的互补视场与立体几何关系被充分利用:
中间相机分别与左右相机组成两组双目,相机之间的距离事先经过标定,因此同一物体在不同视角中的位置差异,可以被换算成有物理单位的深度。
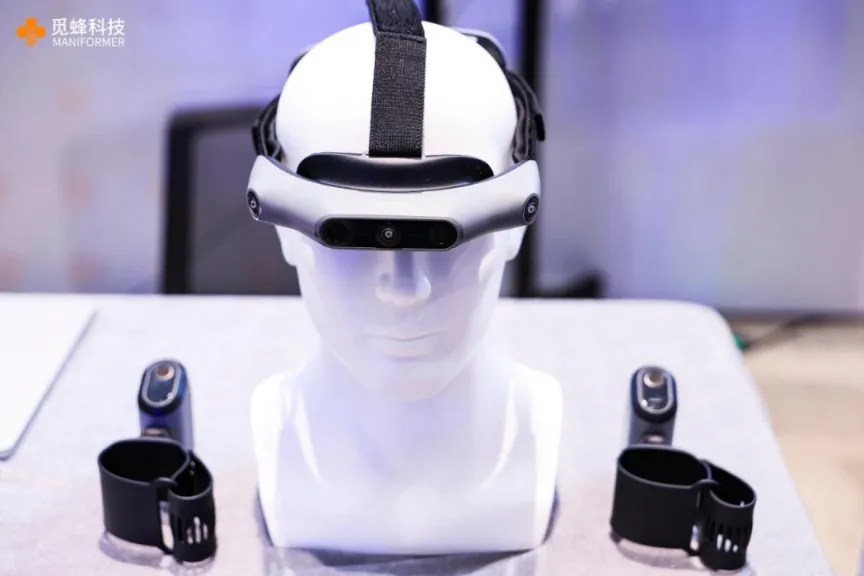
▲图3|头戴设备的价值不只是腾出双手拍摄操作,而是让不同视角在同一时刻观察同一个动作。已知的相机间距为三维重建提供尺度基准:视频中的手不再只是一个随画面大小变化的形状,而有机会恢复到以厘米、米衡量的空间位置。©【深蓝具身智能】编译
这里还存在一个鱼眼相机特有的困难:
宽视角能留下更多手部动作,尤其是画面边缘的手;但直接将鱼眼图像转换成常规透视图,又容易损失边缘视野。
于是,研究为两组双目设计了共享旋转的虚拟平面校正:校正坐标系以基线方向作为第一条轴,把相机之间任意姿态的安装偏差吸收掉;以两个光轴的角平分线作为第三条轴,让公共视场落在校正图像中央。
这样既保证左右图像行对齐、便于匹配,又尽可能多地保留有效视野。
校正之后,两对图像分别送入 FoundationStereo ,各自输出稠密深度图与逐像素置信度;两路结果在中间相机的公共视场内仲裁融合,再经鱼眼模型反投影回中间相机的像素网格,得到与原始鱼眼图像逐像素对齐的稠密深度。
这一设计并不排斥学习模型,而是明确分工:神经网络负责寻找视角之间的匹配,真实尺度由经过标定的相机基线提供。
随后,米制深度可以直接约束三维手腕位置,弥补二维关键点在前后距离上的歧义。
有了这一层几何约束,手腕的位置更可靠了。但连续动作仍可能出现抖动:杯子挡住指尖、工具遮住手掌,都会让某一帧的预测突然偏离前后轨迹。
到这里得到的,还是一帧一帧彼此独立的手部参数。于是,MEgoVista 把逐帧重建作为起点,在整个视频片段上联合优化双手运动。
优化同时顾及三件事:
手模型投影要贴近图像观测,手腕和手指的运动要随时间连续,关节弯曲还应符合基本的解剖活动范围;质量较差的观测会先被筛掉,避免一帧遮挡错误影响整段结果。
由此,系统从一串独立的手部预测,得到更连贯的四维运动记录。
手没动、画面却在动:还得知道人如何转头
即使双手的位置和关节都恢复得不错,第一人称相机仍有一个特殊变量:镜头跟着人的头一起运动。
员工低头看杯子,画面里的手会移动;人侧身去取工具,手与相机之间的关系也会变化。
要把这些记录放到统一世界坐标系,就需要知道每一帧相机自身的位置和朝向。
头戴设备的运动偏偏很容易以转动为主、位移很小。仅靠相邻帧估计运动时,缺少明显的平移基线,尺度和位姿都可能变得不稳定。
MEgoVista 为此创新设计了高精度离线相机轨迹恢复 Pipeline:
-
第一步:Rig 约束的增量重建
① 三路鱼眼共享同一组标定参数,被视为一个广义相机(rig):
三个镜头在同一时刻构成一帧,共用同一个头部位姿。头部运动只解一次,相机之间的几何关系直接由标定提供,不需要在优化里重新猜。
② 关键帧的挑选由惯性和视觉共同把关:
陀螺仪的旋转量和加速度计的能量负责提名候选,保证快速转头不丢帧;候选帧再与上一帧已接受的关键帧做光流比对,跟踪质量差、接近静止的候选被拒掉。
也就是说,动态目标过滤不是一道独立工序,而是关键帧筛选的副产品。
③ 增量建图,再补全帧
只有关键帧进入增量式重建流程,研究采用增量式 Rig-SfM 结构,建完的地图冻结;
非关键帧不再参与联合优化,而是通过与地图做仅位姿的 PnP 求解,逐帧恢复六自由度位姿,在效率和全帧覆盖之间取得平衡。
-
第二步:标定立体度量初始化
重建初始化阶段,系统在关键时间戳上取左右匹配,用标定外参做三角化和非线性优化,得到以真实基线注册的 rig 帧。这里恢复出的米制尺度是量出来的,而不是把轨迹缩放到某个先验上。
-
第三步:事后惯性重力对齐
视觉重建本身不带上下概念。系统把重力方向经由 500 Hz 惯性流传播,并按加速度残差对数据降权(剧烈运动时少信一点);再做平滑处理,作为一次全局旋转施加到整段轨迹上,让轨迹拥有稳定的上下方向。
至此,手部运动与头部运动终于能够表达在同一个空间中。
接下来真正值得看的,是这套系统如何证明自己的厘米和毫米不是“看起来很准”。
4.29 毫米的手部误差,究竟量的是什么?
研究使用了一个相对扎实的验证方式:让受试者佩戴 MEgo View,在由 26 台光学动捕相机组成、采样率为 120 Hz 的 Chingmu 动捕空间内完成动作。头戴设备以 60 fps 记录视频,动捕系统则独立记录头部与手部参考轨迹。
作者并没有直接拿这套参考轨迹打分,而是先核对动捕与相机之间的空间变换。通过额外拍摄的标定板,检查三维参考点投影到真实视频后能否对齐,并排除一些动捕求解中的异常帧。先验证测量链条,再谈重建误差,让后面的毫米级结果更有说服力。
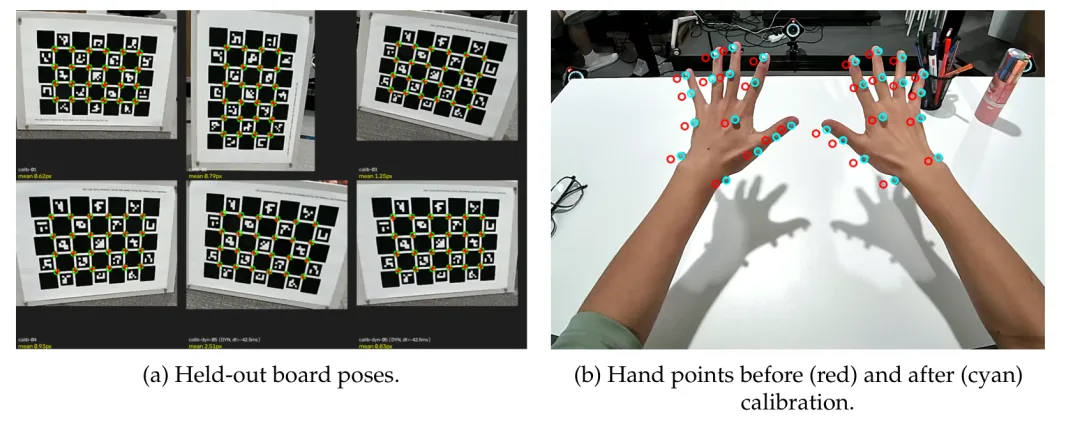
▲图4|毫米级比较首先依赖可靠的坐标标定。左侧的标定板用于检查动捕三维点能否准确投回相机画面,右侧则把这种校准直接带到手部关键点。对于以真实物理尺度为目标的重建系统,“标得准”与“估得准”本来就是同一条测量链上的两步。©【深蓝具身智能】编译
-
先看头部轨迹
在两组测试中,MEgoVista 去掉开头 5 秒后的 ATE RMSE 分别为 2.83 mm 和 0.65 mm;经过离线精化的 ORB-SLAM3 对应为 2.12 mm 和 0.92 mm。
两种方法各有占优的场次,也说明几毫米级的头部跟踪已经是一个竞争相当接近的区间。
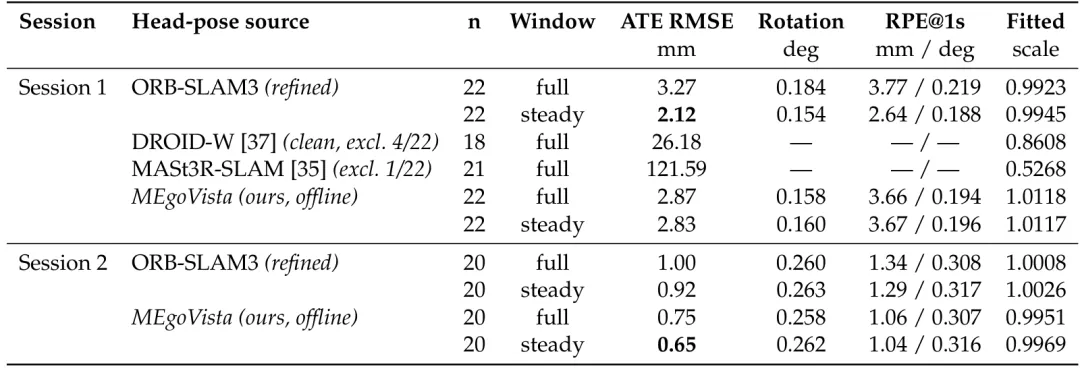
▲图5|同样是毫米级误差,两组测试的领先者并不相同。相比只看某个最小值,更值得注意的是 MEgoVista 在完整片段和稳定阶段之间表现出的差异较小:无需较长的惯性初始化过程,对几十秒的短时操作记录尤其有价值。©【深蓝具身智能】编译
-
手部结果的差异更明显
MEgoVista 的 PA-MPJPE-p 达到 4.29 mm,而 HaWoR 和 Dyn-HaMR 分别为 16.30 mm、49.18 mm;腕部位置指标 CT-p 为 14.30 mm,相较 HaWoR 的 46.70 mm 也明显降低。
在这组动捕评测片段中,手部检测的 Precision、Recall、F1 均为 1.00,时间抖动指标为 1.11 mm/frame²。
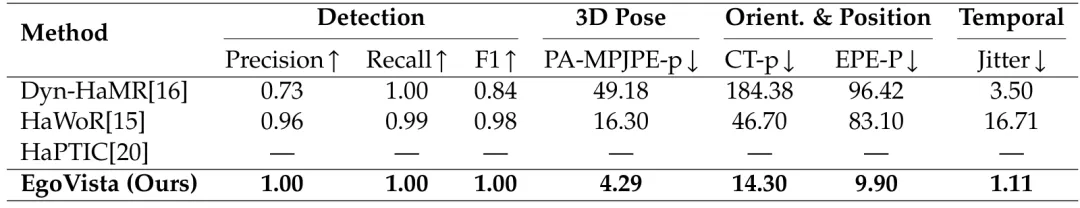
▲图6|这张表最值得放在一起读的是 PA-MPJPE-p 和 CT-p。前者经过对齐,关注手指相对构型;后者直接衡量相机坐标系下的腕部位置。一个回答“手指摆得像不像”,另一个回答“整只手到底在哪里”。MEgoVista 在两个维度上同时缩小误差,正是多视角几何和序列优化结合后的价值。©【深蓝具身智能】编译
这两个指标也构成了理解论文结果的关键。PA-MPJPE-p 在计分前允许旋转、平移和尺度对齐,更适合衡量手指姿态本身;CT-p 则对手腕在相机坐标系中的绝对位置敏感。
对于从人类视频提取机器人动作监督的任务,既要手指姿态准确,也要位置落在真实的物理尺度上。
走出动捕棚,还能应付真实工作中的遮挡吗?
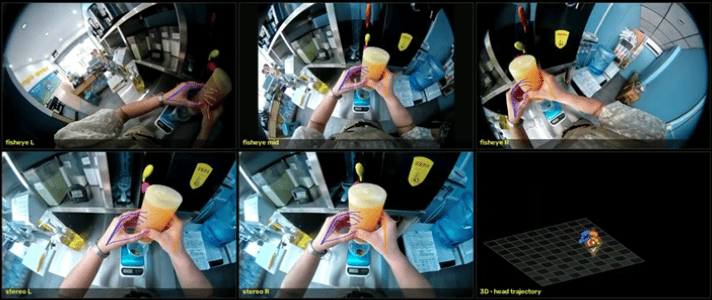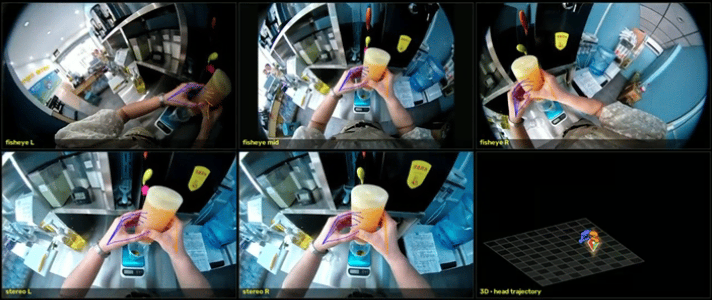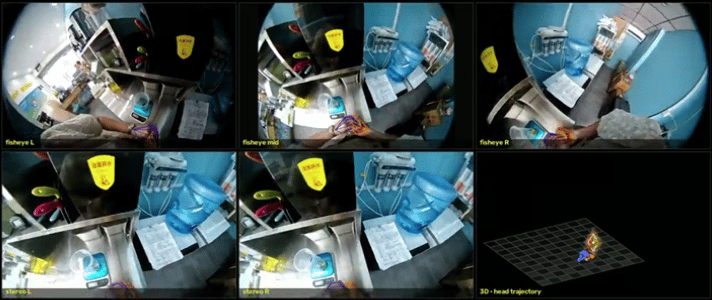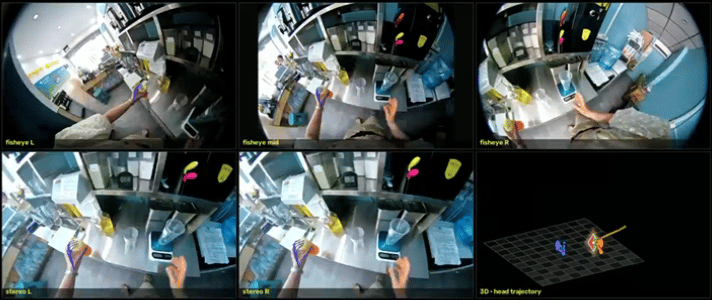
数字是在受控动捕环境中测得的,研究还把方法带到了更复杂的日常操作场景:
-
奶茶制作时双手快速移动
-
美甲时不同人的手频繁交错
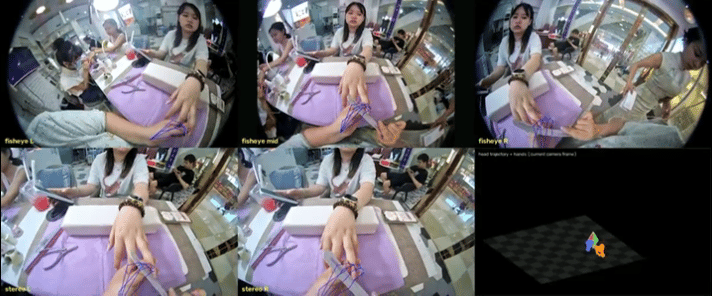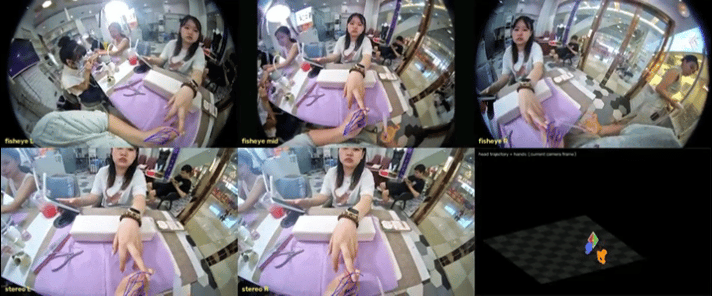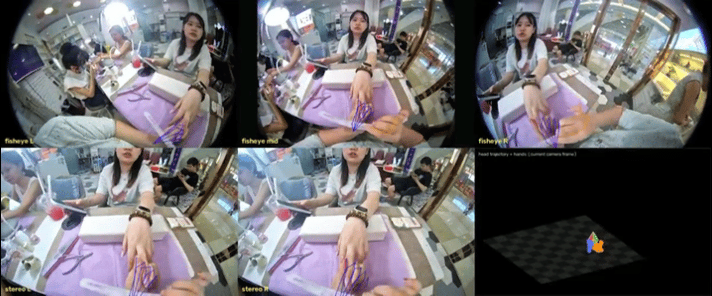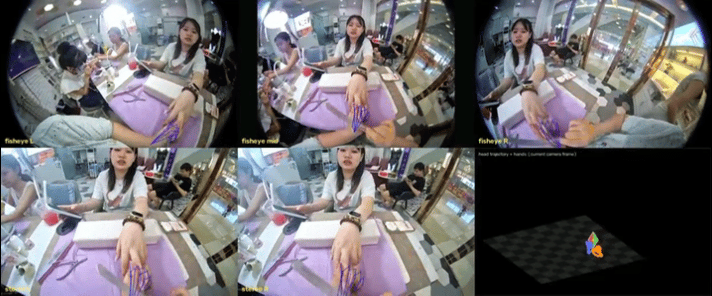
-
清洗动物时手部沾污、外观不断变化
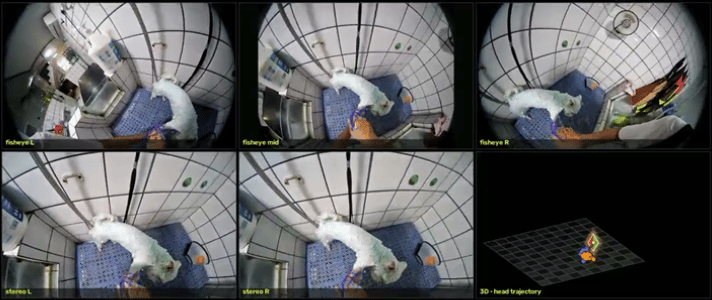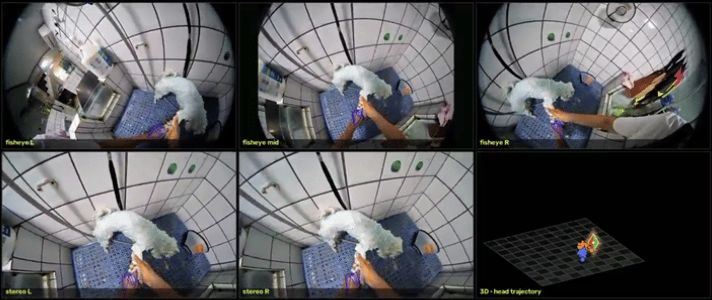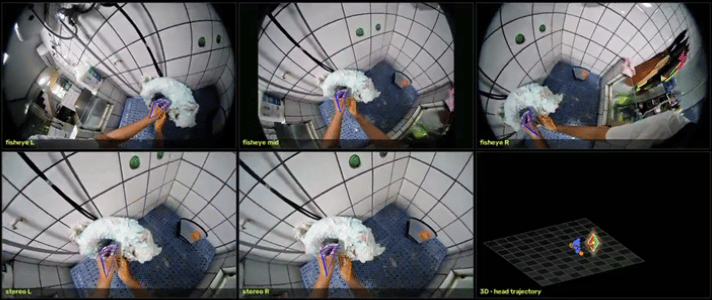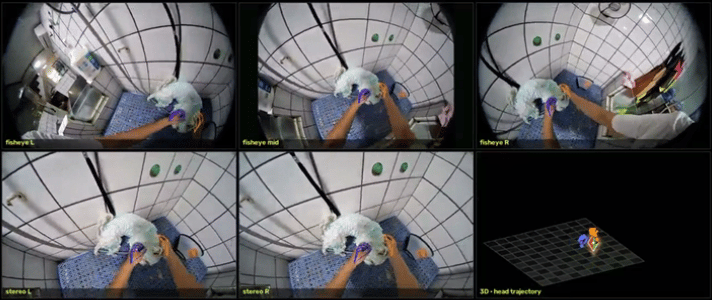
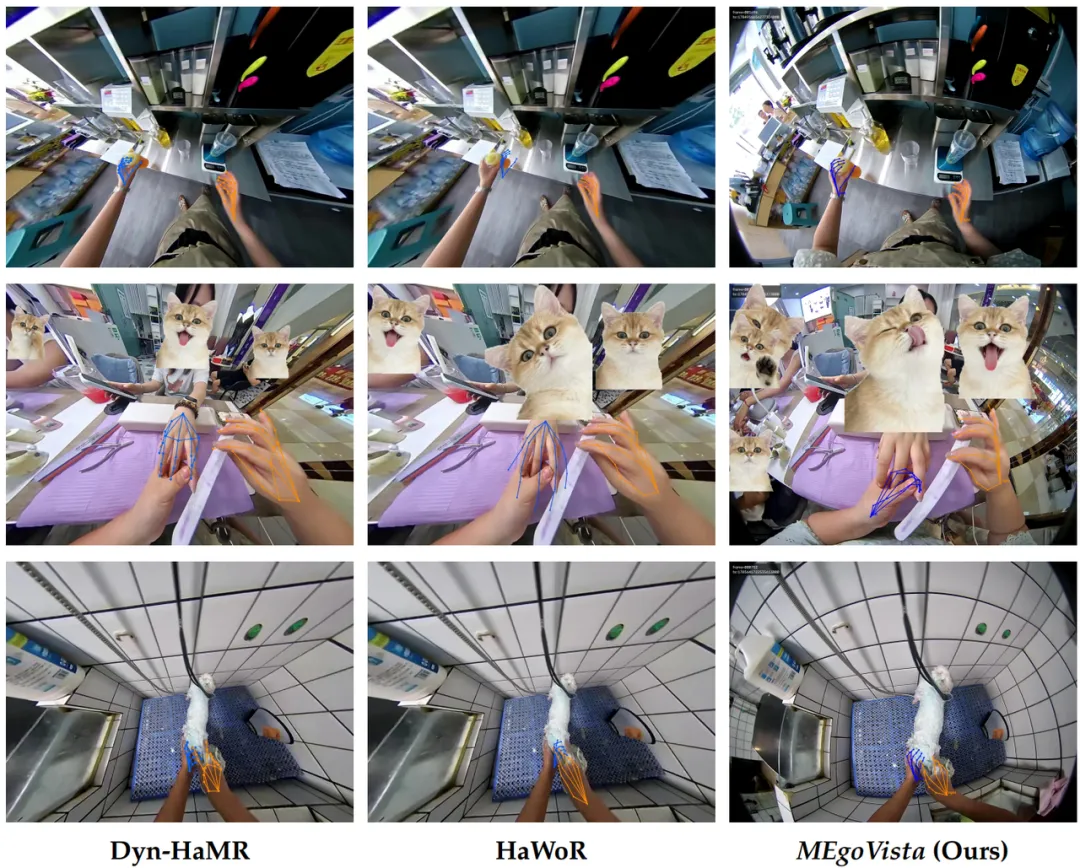
▲图7|三排场景给出了比单纯“贴合得更好”更具体的观察,当两个人的手交错时,重建一副正确的手模型还不够,模型必须知道它到底属于谁。©【深蓝具身智能】编译
同一批演示素材里还包含模具维修这类工业场景,操作者佩戴工业手套,以及餐厅等长时间连续作业的场景。
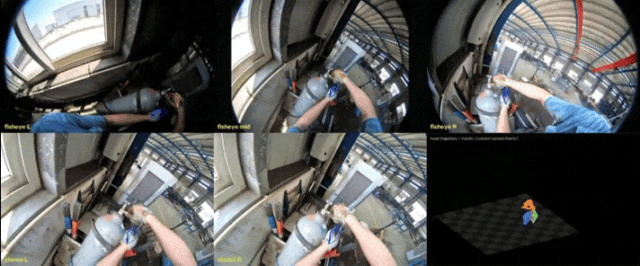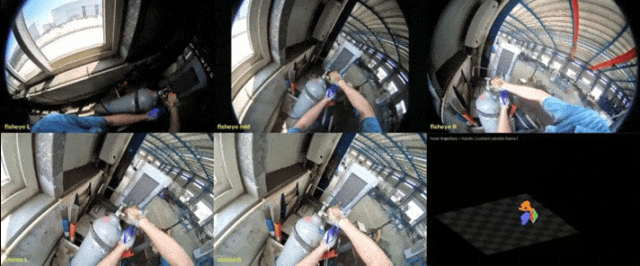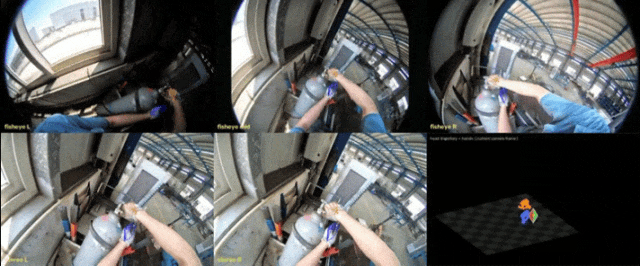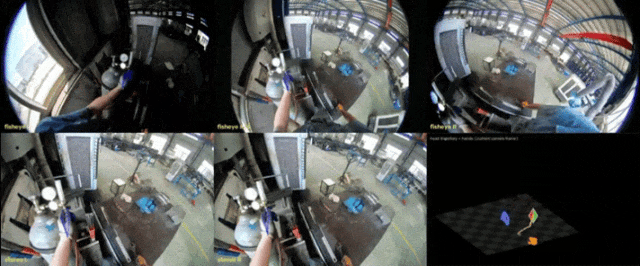
手套会改变手部的外观与轮廓,长时间作业则考验跟踪在大段视频里的稳定性——这两个条件,恰好是消费级演示视频里最少出现、而工业与服务业现场最常见的。
从这些可视化结果中可以看到,MEgoVista 的手部网格在快速运动下保持了较好的贴合,也能够避免把顾客的手接入佩戴者轨迹。
开放环境中的结果以可视化对比为主,和动捕环境里的定量实验形成互补:一个衡量误差大小,一个检验真实工作条件下会遇到怎样的干扰。
从记录人的动作,到让机器人用上这些动作
人类员工可以熟练地取杯、调整握姿、搅拌和放置物品,这些动作每天都在发生。过去难以规模化采集的,不是视频本身,而是与视频同步、具有真实尺度的手部轨迹。
MEgoVista 把这件事拆成了可测量的步骤:先找对手,再量出距离,最后恢复连续运动与头部坐标。
对于机器人学习,这样的数据至少提供了更扎实的起点。
研究者可以从中提取腕部路径、手指关节变化和操作节奏,再进一步处理人手到机器人手的动作映射、接触力建模和策略训练。人的运动还不能直接当作机器人的控制命令,但它已经不再只是难以量化的视觉片段。
而要让这类数据真正变成机器人的教材,卡点从来不在某个单点技术上,而在于三层能力能不能同时成立:采得出来、接得住、用得上。觅蜂科技给出的结构,是硬件、平台、引擎三位一体。
-
硬件解决"采得到"
MEgo 系列走的是无本体采集路线——不依赖某台特定机器人,先完整记录人的真实操作,再通过轨迹重建和动作转换去适配不同模型与本体。
MEgo View 与 MEgo Gripper 可单独使用、也可协同,分别覆盖头戴视角与末端夹爪两条采集路径。
-
平台解决"接得到"
9 月 23 日,觅蜂科技在上海发布觅蜂派:用户下载 App 领取任务,佩戴 MEgo 设备在零售、仓储、制造、家庭等真实场景中完成指定操作,按审核后的有效时长获得报酬。据官方披露,平台目前覆盖 22 大类场景、5000 多个任务和 5 万多个真实环境;内测一个月,注册用户达 2 万人,累计产生 1.3 万份采集任务提交。
-
引擎解决"用得上"
MEgo Engine 完成数据处理、标注、质量评估与交付,把真实操作拆解成抓、拿、放、拧、按等 120 多种标准原子动作,再经过位姿重建与动作映射,转成模型可训练的数据。
MEgoVista 这类工作的位置,也就清楚了:它补的正是"空间重建"这一环的精度基线。
从第一视角采集,到多视角三维重建,再到动作数据质量评估,觅蜂科技正在把“人类视频”逐步变成“机器人可用的动作经验”。
Ref
MEgoVista: Multi-view Ego-aware Motion Estimation for Metric 4D Hands and Head in the Wild
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇