为了将算法知识真正转化为解决问题的能力,我们开设了《算法详解》专栏。每一期都会拆解一个经典算法,不只讲公式,更希望把它为什么出现、真正解决什么,以及放进实际系统以后会遇到哪些问题讲清楚。
这一期,我们来讲一个在自动驾驶、机器人、无人机、SLAM 和目标跟踪里都绕不开的算法:
卡尔曼滤波(Kalman Filter)。
很多人第一次接触它,会把它理解成一种“让数据变平滑”的滤波方法。
但卡尔曼滤波真正有意思的问题其实是:
当模型预测和传感器测量都不完全可信时,我们到底应该相信谁?
假设一辆汽车正在向前行驶,我们想知道它现在位于道路上的什么位置。
最直接的方法当然是看 GPS。
但 GPS 并不会每次都准确落在真实位置上。车辆明明平稳向前,它给出的位置却可能一会儿偏前,一会儿偏后。
好在汽车还有另一条信息。
假设上一时刻,我们知道车辆位于 90 m,并且正在以大约 10 m/s 的速度前进。那么 1 秒以后,即使 GPS 暂时没有更新,也可以根据运动模型预测:
车辆现在大约应该在 100 m。
于是对于同一个位置,我们有了两种来源的信息:
一种来自模型预测,另一种来自传感器测量。
麻烦也随之而来。
假设下一时刻,模型预测车辆位于 110 m,GPS 却告诉我们:
108 m。
到底哪个是真的?
直接相信 GPS 不一定对,因为 GPS 本身有噪声;直接相信模型也不一定对,因为车辆可能已经减速、轮胎可能打滑,之前估计的速度本身也可能存在误差。
于是问题变成:
预测不完全可信,测量也不完全可信,怎么利用两边的信息得到更合理的状态?
卡尔曼滤波解决的正是这件事。
这里的“状态”也不一定只是位置。
对于汽车,可以同时估计位置和速度;对于无人机,还可能包括三维位置、速度和姿态;机器人系统甚至会把 IMU bias 等内部变量一起放进状态里。
所以卡尔曼滤波真正回答的不是:
传感器刚刚测到了什么?
而是:
综合目前掌握的全部信息以后,系统现在最可能处于什么状态?
这就是状态估计(State Estimation)。
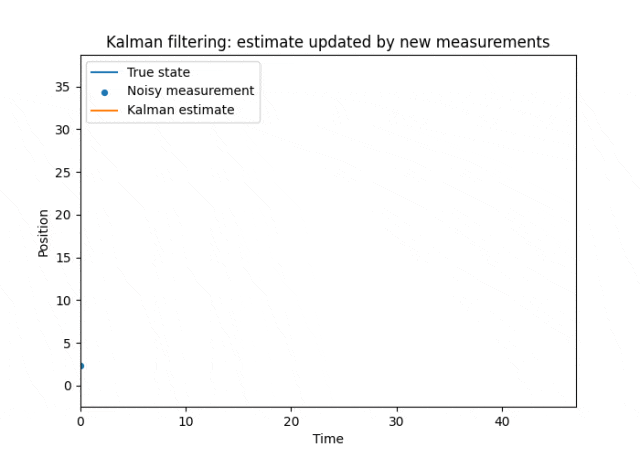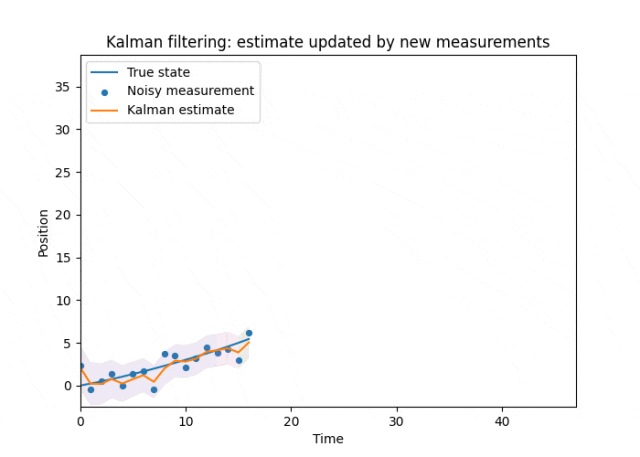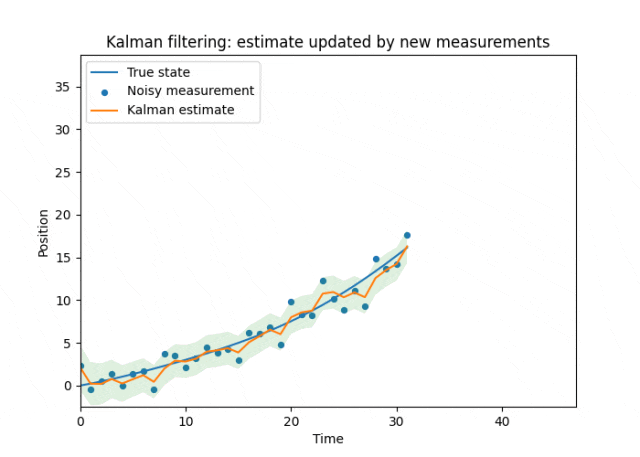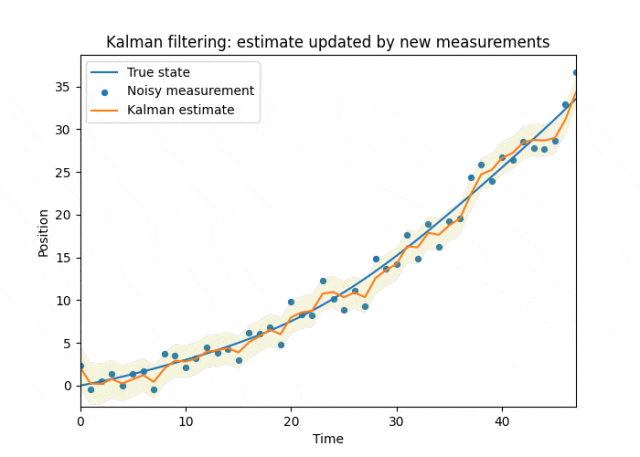
图1 | 卡尔曼滤波会随着目标不断运动,持续利用新的带噪测量修正自己的状态估计。图中真正值得关注的不只是估计值本身,还有估计结果周围不断变化的不确定范围。©【深蓝AI】编译
继续刚才的例子。
模型说 110 m,GPS 说 108 m。
最简单的办法当然是取平均:
109 m。
但这实际上默认了一个前提:
模型和 GPS 一样可靠。
现实中通常不是这样。
如果车辆正在开阔道路上,GPS 信号很好,而模型已经很久没有得到准确观测修正,那么这一次应该更多相信 GPS。
反过来,如果汽车正在高楼密集区域,GPS 突然开始乱跳,而短时间内车辆运动非常稳定,我们又应该更多相信模型。
所以真正的问题并不是:
110 和 108 怎么平均?
而是:
这两个答案分别有多可信?
这就引出了卡尔曼滤波里非常重要的一个概念:
Kalman Gain,卡尔曼增益。
可以把它理解成一个不断变化的“信任旋钮”。
旋钮一边是模型预测,另一边是传感器测量。
如果当前预测已经很不确定,而传感器很可靠,就把结果明显拉向测量;如果模型预测很稳定,而当前传感器很吵,就只接受一小部分测量修正。
所以即使每一次面对的都是“预测 110 m、测量 108 m”,最终得到的结果也不一定相同。
因为卡尔曼滤波关心的不只是两个数字,还关心:
这两个数字背后的不确定性。
预测和测量之间的差,在卡尔曼滤波里通常被称为 Innovation,也就是“新息”。
模型预测 110 m,GPS 测到 108 m,这次测量相当于告诉系统:
你刚才可能往前估多了。
至于这 2 m 到底应该纠回来多少,则取决于这次测量到底值不值得信。
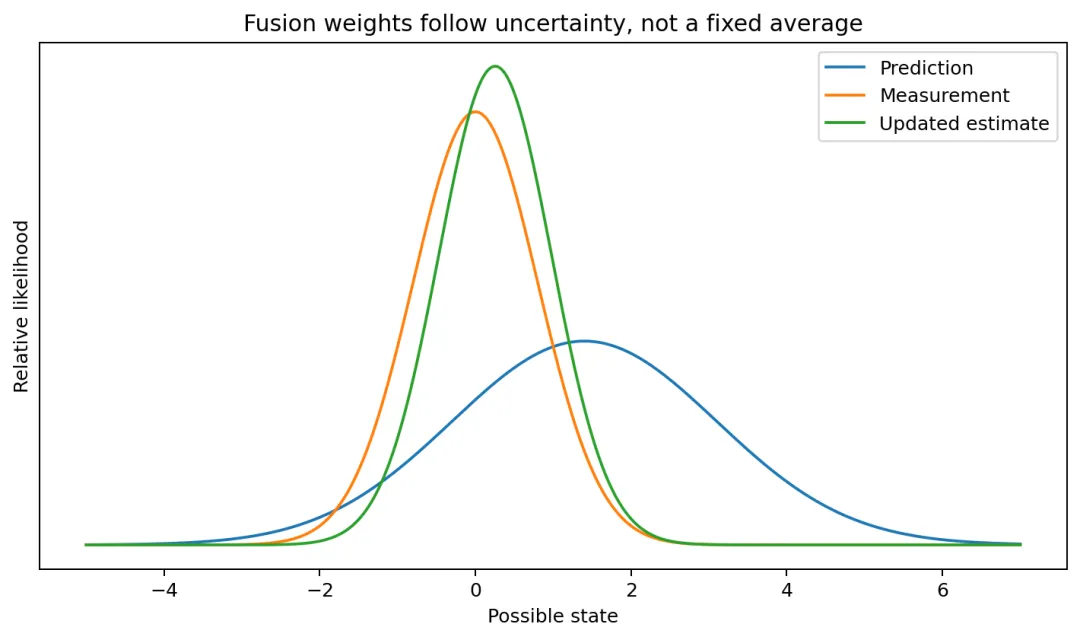
图2 | 模型预测和传感器测量都不是一个绝对准确的点,而是各自带着不确定范围。卡尔曼滤波根据两边的不确定程度进行融合,结果通常会更多靠近更可信的一侧,而不是机械地落在两者正中间。©【深蓝AI】编译
这也解释了一个很常见的误解:
卡尔曼滤波并不等于低通滤波或者滑动平均。
普通平滑方法同样可以让一条抖动的曲线变漂亮。
但平滑并不意味着估计更加准确。
例如汽车突然开始刹车,如果还在不断平均过去的位置,结果可能非常顺,却明显滞后于车辆真实运动。
卡尔曼滤波真正想做的并不是“把线修平”,而是:
利用模型和测量,尽可能合理地估计真实状态。
平滑很多时候只是结果,而不是目的。
很多人第一次真正被卡尔曼滤波劝退,就是从 P、Q、R 开始。
三个字母,再配上几个矩阵,算法一下子从一个挺直观的问题变成了线性代数。
其实先不用看公式。
可以先记住三句话:
P:我对当前状态估计有多没底。
Q:我的运动模型有多不靠谱。
R:传感器的测量有多不靠谱。
P:我对当前答案有多确定?
假设滤波器现在告诉我们:
车辆位于 110 m。
P 进一步描述的是:
我对这个 110 m 到底有多大把握?
如果系统刚启动,连初始位置都不是特别清楚,那么自然比较没底。
随着越来越多的信息进入,状态估计逐渐稳定,我们可能越来越确信自己的结果。
但如果汽车进入隧道,GPS 消失,只能依靠模型不断预测,情况又会反过来。
预测 1 秒,问题可能不大。
连续预测 30 秒呢?
轮胎打滑、速度偏差和模型误差都可能不断积累。
所以卡尔曼滤波不仅把状态向未来传播,也会把对状态的不确定性一起传播。
Q:我有多敢相信自己的模型?
假设运动模型认为汽车短时间内会保持当前速度。
现实里,驾驶员可能突然刹车,车辆可能转弯,轮胎也可能打滑。
这些模型没有完整描述出来的变化,都意味着真实系统有可能偏离预测。
Q 描述的就是这部分过程噪声。
直观地说:
Q 越小,滤波器越相信自己的模型;Q 越大,它越愿意承认真实世界可能突然“不按模型走”。
如果 Q 设置得过小,车辆明明已经减速,滤波结果却可能迟迟跟不上。
因为系统还在坚持:
我的模型应该没问题,可能只是传感器在抖。
R:这个传感器到底有多靠谱?
R 描述的是测量噪声。
GPS、摄像头、雷达、IMU 给出的数字都不是绝对准确的。
如果 R 很小,相当于告诉滤波器:
这个传感器很准,多听它的。
R 很大,则相当于说:
这次测量比较吵,不要轻易被它带跑。
因此 Q 和 R 之间实际上存在一个非常直观的关系:
模型不可信、传感器可信,就更多依赖测量;
模型可信、传感器噪声大,就更多依赖预测。
Kalman Gain 就是在当前的不确定性条件下,计算这一轮到底应该信谁多少。
这也让卡尔曼滤波的调参变得更容易理解。
估计结果跟着传感器一起乱抖?
可能是对测量过于信任。
真实运动已经明显发生变化,估计结果却慢吞吞地跟不上?
可能是模型被赋予了过高的信任。
没有测量很长时间以后,系统仍然对自己的预测异常“自信”?
那就需要检查预测过程中不确定性的增长是否合理。
真正有用的不是死记 Q、R 应该填什么数字,而是看到系统行为以后,知道应该往哪里排查。
理解了前面的内容,完整流程反而非常简单。
卡尔曼滤波不断重复两件事:
预测,然后更新。
假设系统已经估计出汽车位于 100 m,并且正在以约 10 m/s 的速度前进。
1 秒以后,即使新的 GPS 还没有到,我们也可以先根据模型预测:
车辆大约应该到达 110 m。
这是 Prediction。
因为这次结果来自模型推算,而不是直接测量,对状态的不确定性也会随之变化。
随后 GPS 给出新的位置:
108 m。
系统比较预测和测量之间的差异,再结合当前模型和 GPS 各自的不确定性,决定应该修正多少。
这是 Update。
更新之后,不只是位置改变了,对这个位置的“信心”也会一起变化。
然后下一轮继续:
预测 → 测量 → 修正 → 再预测。
不断循环。
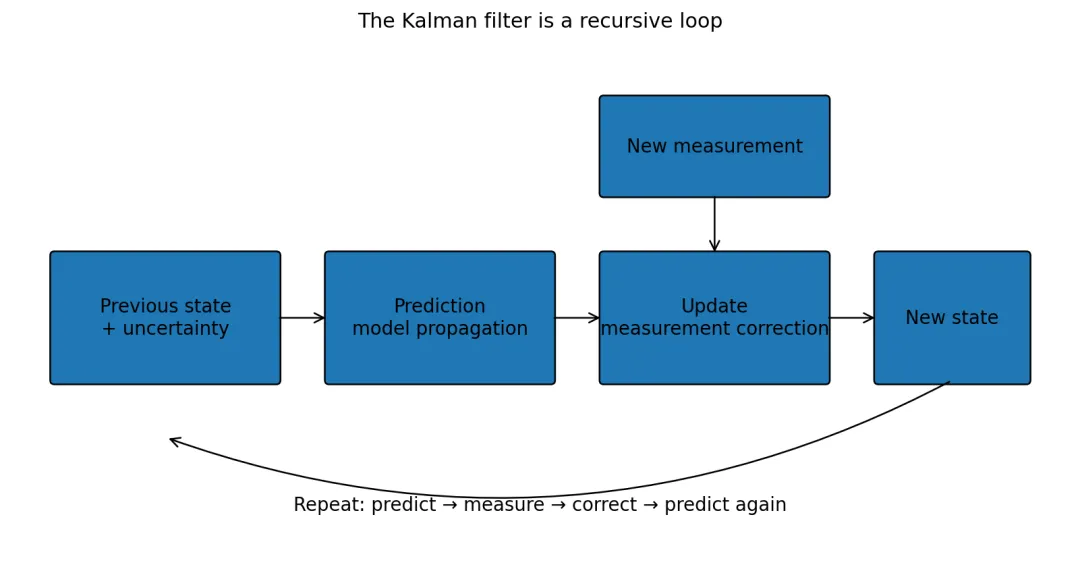
图3 | 卡尔曼滤波本质上是一个持续运行的闭环:上一时刻的状态经过模型向前预测,再利用当前测量进行修正;新的状态和不确定性随后进入下一轮预测。©【深蓝AI】编译
所以如果暂时把所有矩阵公式都拿掉,卡尔曼滤波其实可以压缩成几句话:
我先根据之前的信息猜一下现在在哪里;
再看看新的传感器测到了什么;
判断两边各自有多靠谱;
最后修正状态,以及对这个状态的信心。
那些看起来复杂的公式,只是在位置、速度、姿态等多维状态里,把这几件事精确算出来。
到这里还有一个现实问题。
前面的汽车一直在做最简单的直线运动。
但真实机器人显然没有这么规整。
汽车会转弯,无人机会改变姿态,机器人同时存在平移和旋转,传感器观测和系统状态之间的关系也可能是非线性的。
而最基础的 Kalman Filter 使用的是线性状态转移和测量模型。
于是机器人里经常出现另一个名字:
Extended Kalman Filter,扩展卡尔曼滤波,EKF。
EKF 并没有推翻前面的逻辑。
它依然是:
预测,然后根据测量更新。
P、Q、R 和 Kalman Gain 也依旧存在。
真正“扩展”的地方,是让这套方法可以处理非线性模型。
可以粗略理解成:
虽然整个系统是弯的,但在当前位置附近截取很小的一段,可以先把它近似成直的。
然后继续沿用 Kalman Filter 的预测和更新框架。
数学上,这一步通常需要使用 Jacobian 描述非线性模型在当前位置附近的变化。
如果系统非线性非常强,局部线性近似又可能不够理想,因此后来还有 UKF 等其他变体。
不过从整个家族的思想来看,最核心的一件事始终没有变化:
先预测,再用新的观测不断纠正预测。
现在把卡尔曼滤波真正放进一辆车或者移动机器人里。
假设机器人同时拥有:
GPS、IMU 和轮速计。
三种传感器观察的是同一个机器人,却各有所长,也各有自己的问题。
GPS 能够提供全球位置参考,但在建筑物遮挡、隧道等环境里可能明显恶化。
轮速计能够连续反映车辆运动,但轮胎打滑、轮径误差都会导致长期累计误差。
IMU 更新频率高,可以快速测量角速度和加速度,但噪声和 bias 经过积分以后,同样会不断累积。
所以真正的“传感器融合”不是:
三个传感器的数字放在一起求平均。
一种典型做法,是先维护一个共同状态,例如机器人的位置、速度和姿态。
IMU 和轮速数据不断帮助系统向前预测。
新的 GPS 位置到来以后,再利用它对长期漂移进行修正。
这些观测甚至不必同时到达。
谁有新的信息,谁就在对应时刻参与一次状态更新。
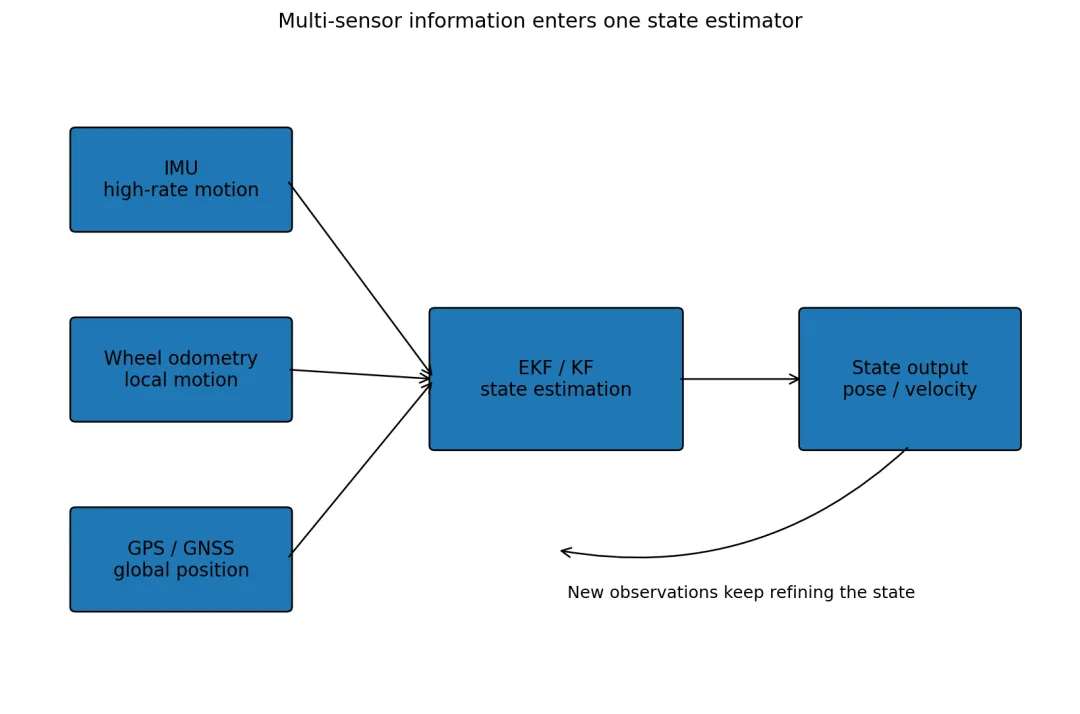
图4 | 一个典型的多传感器状态估计系统。IMU 可以高频提供运动信息,GPS/GNSS 提供全局位置约束,轮速计补充局部运动信息,EKF 则把不同频率、不同噪声特性的观测统一到同一个状态估计过程中。©【深蓝AI】编译
这也是为什么某一个传感器暂时失效,并不意味着整个定位系统立即失效。
GPS 短时消失时,系统仍然可以根据其他运动信息继续预测。
GPS 重新出现以后,再利用新的测量纠正累计漂移。
这时候卡尔曼滤波真正发挥的价值,并不是“找出最好的一个传感器”,而是:
让多个都不完美的信息源彼此补偿。
卡尔曼滤波的数学推导很漂亮,但真正把它放到机器人上以后,问题往往才刚刚开始。
初始化
滤波器启动时,不仅需要一个初始状态,还需要告诉系统:
你对这个初始状态有多确定?
如果机器人明明不知道自己精确在哪里,却给了一个非常“自信”的错误初始值,那么后面的真实测量出现以后,滤波器反而可能不愿意快速修正自己。
一个错误但极度自信的答案,有时候比一个粗糙但诚实的不确定答案更麻烦。
时间戳
IMU、GPS、相机的频率和延迟通常不同。
卡尔曼滤波的预测又和时间直接相关。
如果拿一条已经过时的测量去修正当前状态,即使所有公式都完全正确,最后也可能得到错误结果。
所以真正的多传感器融合系统,往往还必须处理:
时间同步、延迟和坐标系转换。
异常值
GPS 平时可能只偏一两米,但偶尔也可能突然跳出去几十米。
卡尔曼滤波并不会天然知道:
这一帧 GPS 坏了。
如果仍然把它当成一次普通测量,就可能直接把状态估计拉走。
因此工程系统通常还会根据 Innovation 等信息判断观测是否离谱,对异常测量进行拒绝或者降权。
“看起来很平滑”不等于“估计得准”
这是最容易踩的坑。
把系统调得更加相信模型,轨迹可能立刻变得非常漂亮:
不抖了,也更顺了。
但真实车辆已经转弯,估计还慢半拍;真实目标突然加速,模型却仍然坚持原来的运动趋势。
所以评价一个状态估计器,不能只看曲线是不是足够顺。
还要看:
它离真实状态到底有多远?
真实运动发生变化时能不能及时跟上?
传感器短时失效以后能不能恢复?
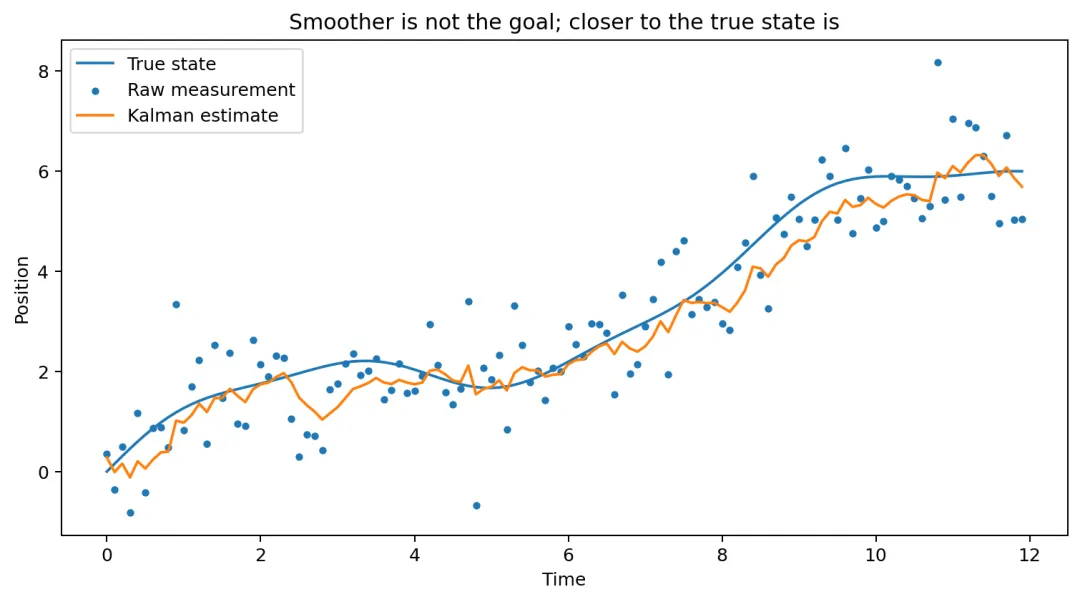
图5 | 原始测量会围绕真实状态明显波动,而卡尔曼滤波通过运动预测和连续观测进行修正。判断滤波效果时,不能只看结果是否更加平滑,更重要的是估计是否真正靠近真实状态。©【深蓝AI】编译
回到最开始的问题。
模型预测车辆在 110 m。
GPS 测量车辆在 108 m。
车辆到底在哪里?
卡尔曼滤波不会机械地回答:
109 m。
它反而会继续问:
模型有多可靠?
GPS 有多可靠?
当前状态估计本身有多确定?
不同的答案,会得到不同的融合结果。
这也正是卡尔曼滤波真正值得理解的地方。
它不是简单把两个“不准确的数字”,平均成一个“更准确的数字”。
真正的核心是:
在不完美的信息里持续估计系统状态,并且始终记得,这个答案本身也存在不确定性。
真实世界里的机器人永远看不到一个完全无噪声的世界。
传感器会错,模型会错,预测会漂。
真正重要的,并不是寻找一个永远正确的信息源。
而是知道:
当手里的信息都不完美时,应该怎样合理地相信它们。
这就是卡尔曼滤波。
参考资料
1. R. E. Kalman, A New Approach to Linear Filtering and Prediction Problems, 1960.
2. Greg Welch, Gary Bishop, An Introduction to the Kalman Filter.
3. MathWorks, Linear Kalman Filters.
4. ROS robot_localization Documentation.
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
