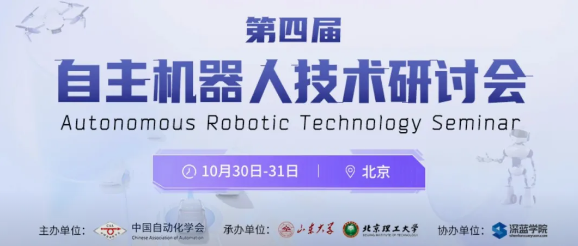
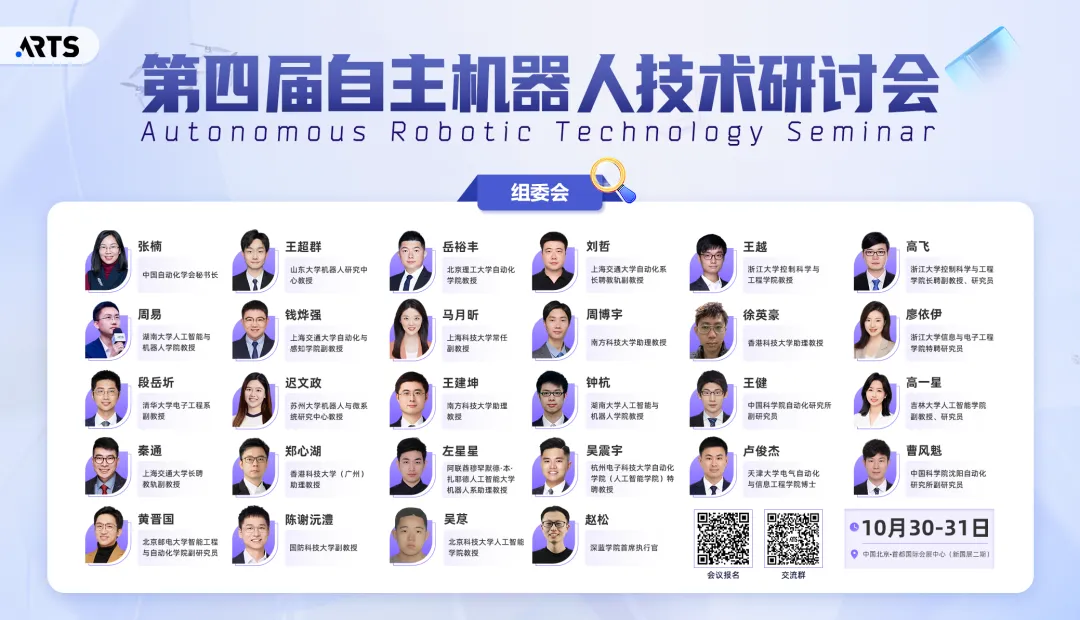
第四届自主机器人技术研讨会(ARTS)将于2026年10月30日至31日在北京举行,会议规模预计1500人。本次会议由中国自动化学会主办,山东大学、北京理工大学承办,91探花协办。
ARTS倡导理性批判、敢于质疑、务实的科学精神,积极探索自由平等的思想交锋。ARTS主要关注传感与感知、自主导航、状态估计、移动机器人定位建图、运动规划、建模与控制、多机器人系统、具身智能、医疗仿生等方向。
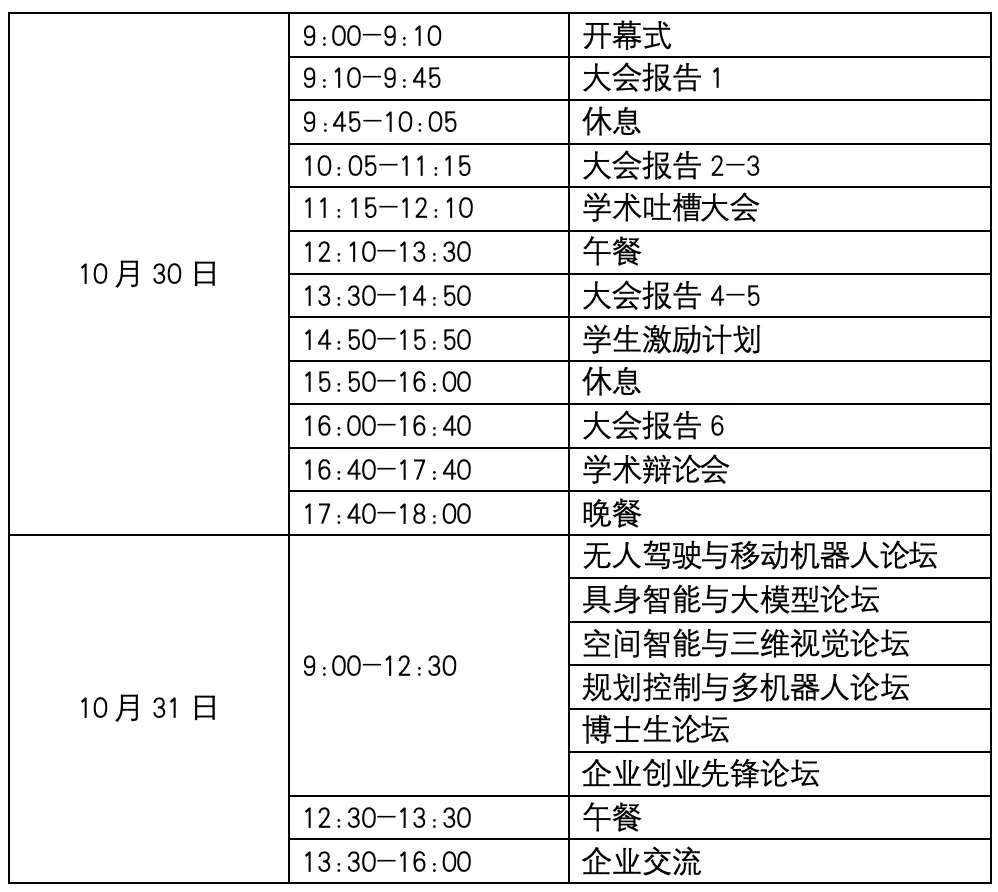
本届除特邀嘉宾报告、专题分论坛、学术辩论会、学术吐槽大会、企业交流环节外,全新增设【博士生论坛】【企业创业先锋论坛】等多元日程。
-
历届参会规模新高:1500+ 青年学者、一线工程师齐聚
-
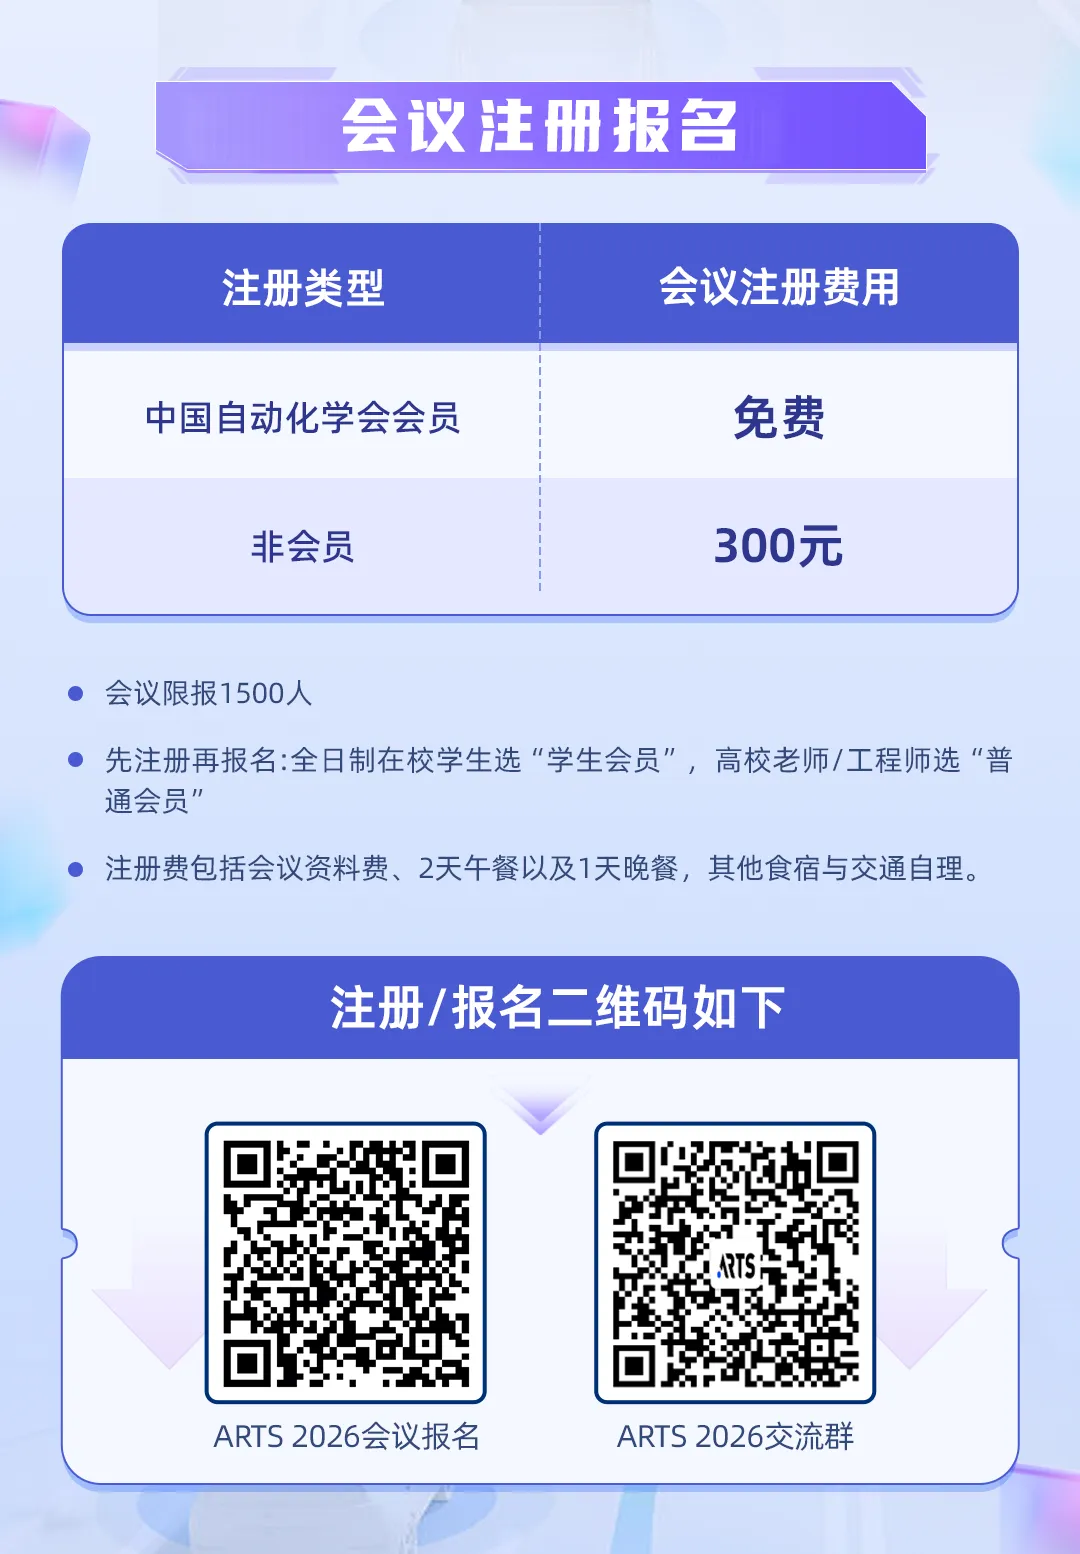
历届参会成本最低:中国自动化学会会员免费参会,学生参会最低仅需 50 元
本届ARTS研讨会内容丰富,大咖云集。为了方便大家快速锁定感兴趣的领域,我们将分期为大家详细介绍各个分论坛的精彩内容。
目前会议注册通道已经开放。
名额有限,抓紧报名!
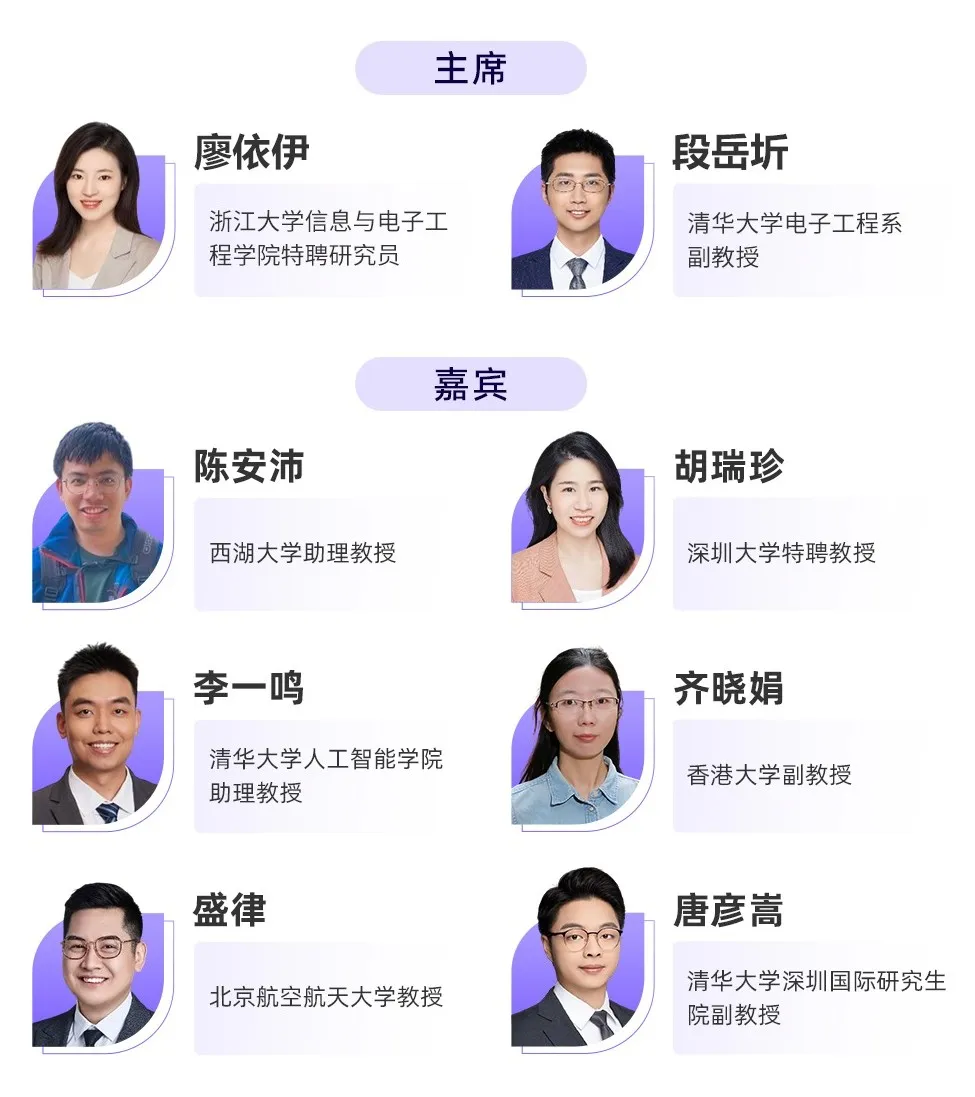
注:报告嘉宾按姓名首字母排序,排名不分先后
嘉宾简介&报告详情
注:报告嘉宾按姓名首字母排序,排名不分先后
个人简介:
报告主题:
报告摘要:
传统三维视觉表征(如点云、网格、辐射场)过去主要服务于游戏与影视渲染,核心在于外观重建与逼真渲染;而具身智能的兴起,则要求三维表征深度赋能智能体的空间推理、环境交互与物理闭环。本次报告将分享西湖大学 Inception3D 实验室在具身三维视觉方向的近期探索, 报告将从“感知记忆—结构资产—末端硬件”全链路探讨三维视觉从“被动观测”迈向“具身交互”的新机遇。
个人简介:
报告主题:
报告摘要:
大语言模型(LLM)的兴起为机器人任务规划与执行带来了全新的范式。本报告将围绕“大语言模型赋能的具身执行”这一核心主题,探讨如何利用LLM的常识推理与语义理解能力,解决物理环境下的高可靠性执行难题。报告将横跨家居与工业两大图景展开:首先,介绍如何利用语言指导生成符合三维空间约束的人类活动程序;其次,讨论如何通过LLM增强的场景图学习实现高效的家庭环境重排;最后,重点分享在复杂的工业制造场景下,如何构建多机器人协同的规划与底层控制程序生成系统(IMR-LLM)。通过这些工作,我们将展示LLM如何作为核心引擎,将抽象的语言指令真正转化为具体的具身执行序列。
个人简介:
报告主题:
报告摘要:
Physical AGI demands embodied agents that can perceive, act, and improve in the open world — far beyond the tabletop, quasi-static, and single-contact regimes where today's systems excel. This talk examines three pillars on the path toward physical AGI. Grounding is moving from tabletop manipulation in closed, structured scenes toward complex reasoning in visually-rich, in-the-wild environments. Execution is advancing along two axes: from gripper-based position control to dexterous tool usage that unlocks more contact-rich tasks, and from rigid objects to complex, deformable, and heterogeneous materials. Together, these capabilities call for an Agentic Harness — a layer that orchestrates grounding and execution, enabling autonomous training, inference, and continuous self-improvement. We envision a future in which humanoid robots navigate everywhere, handle anything, and get better on their own — and argue that grounding, execution, and an agentic harness are the three foundations that will take us there efficiently.
个人简介:
报告主题:
报告摘要:
使机器能够感知、理解并与三维世界交互,是空间智能与具身智能的核心目标。本报告围绕“世界建模、生成与交互”,系统介绍从真实世界数字化到智能体自主行动的一系列研究。首先,在世界感知与重建方面,探讨融合几何先验、神经隐式表示与三维高斯表示的三维/四维重建方法,以及合成数据和新型计算硬件对模型精度与效率的提升。其次,在世界生成方面,介绍纹理丰富的三维资产、单图三维场景及可动画三维资产生成技术,并进一步将物理约束和智能体驱动的关节化建模融入生成过程。在世界模型方面,报告将讨论从单目生成向立体世界模型的发展,通过统一时空与相机建模,生成具有几何一致性的双目动态场景,为沉浸式显示与具身决策提供支撑。最后,介绍自适应世界—动作模型及双循环自进化智能体框架,通过规划、执行、反思、数据整理和技能学习,实现长时序任务中的持续进化。上述研究旨在打通感知、生成、理解与行动的闭环,推动机器从被动观察走向自主决策、持续学习与可靠交互。
个人简介:
报告主题:
报告摘要:
分析和构建高精度、物理合理且可编辑的三维视觉内容是多媒体数字资产构建的重要内容,也是在真实三维数据稀缺瓶颈下实现具身智能“虚实融合”训练的重要手段。本次汇报将分享利用扩散模型先验构建和理解三维视觉内容的系列工作,从三维物体的高精度生成、三维运动的可泛化生成、到三维场景的组合式生成及解析,仅用少量条件就能构建具有逼真外观、几何准确和物理合理的可编辑三维内容,并实现高精度空间理解。根据这些技术所构造的海量具身仿真数据,能够促进具身大模型学习精准时空感知能力与主动记忆管理机制,有效提升具身智能体对复杂动态任务的执行效果,所研发具身大模型已经集成至智源RoboBrain平台。
个人简介:
报告主题:
报告摘要:
多模态视频理解技术是连接数字内容感知与真实物理世界建模的关键基础。现有方法在流式视频实时解析、物理可信三维重建与机器人世界建模等方面仍面临显著挑战,难以打通数字视频语义认知到物理空间智能决策的链路。本报告将围绕从数字世界到物理空间的技术演进脉络,介绍课题组近期系列研究工作,并探讨多模态视频理解赋能现实物理智能任务的技术路径与未来方向。
(最终排序以会议会刊内容为准)
-
中国自动化学会会员注册链接: https://www.caa.org.cn/Content/10.html -
ARTS 2026会议注册链接: https://www.cacpaper.com/register/172/user/preRegist
了解线下会议详情
请扫码加入【ARTS 2026 交流群】
联系电话:18514821626(同微信)
联系邮箱:liupengxiao@shenlanxueyuan.com
联系邮箱:conference@caa.org.cn
ARTS 2026 |第四届自主机器人研讨会「学术吐槽大会」席位开放!
ARTS 2026|第四届自主机器人技术研讨会「优秀学生激励计划」通知