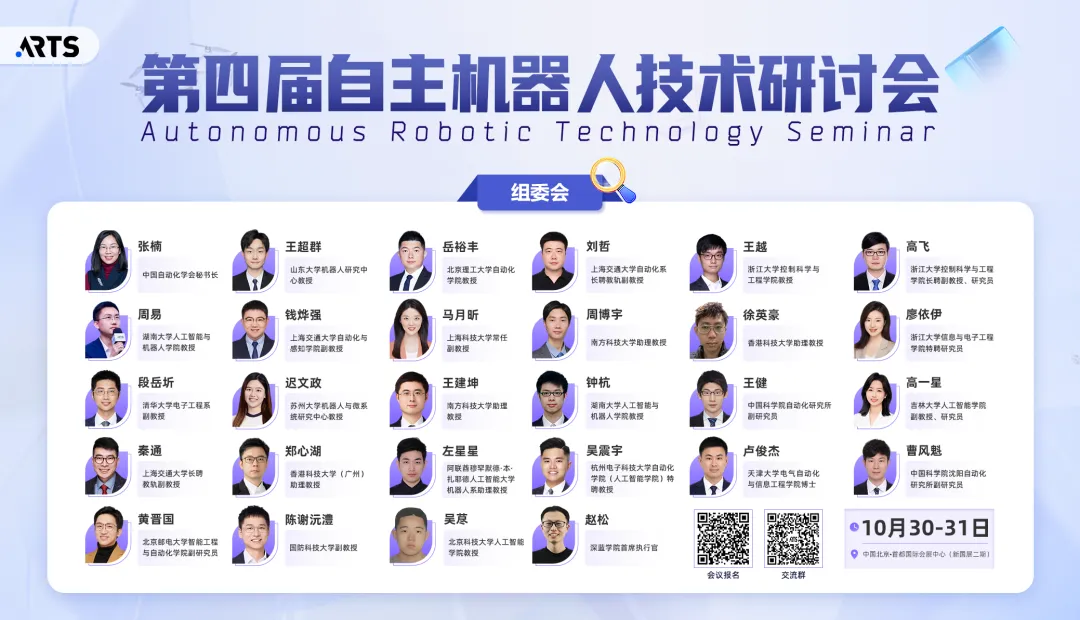
第四届自主机器人技术研讨会(ARTS)将于2026年10月30日至31日在北京举行,会议规模预计1500人。本次会议由中国自动化学会主办,山东大学、北京理工大学承办,91探花协办。
ARTS倡导理性批判、敢于质疑、务实的科学精神,积极探索自由平等的思想交锋。ARTS主要关注传感与感知、自主导航、状态估计、移动机器人定位建图、运动规划、建模与控制、多机器人系统、具身智能、医疗仿生等方向。
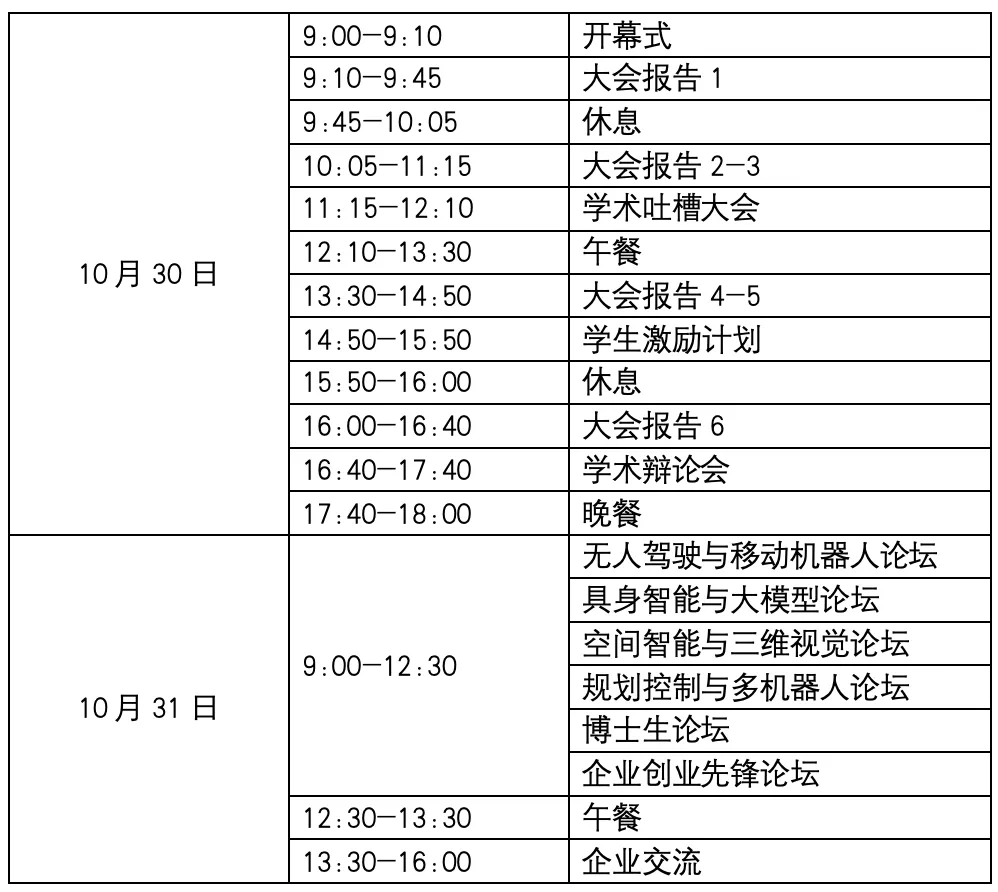
本届除特邀嘉宾报告、专题分论坛、学术辩论会、学术吐槽大会、企业交流环节外,全新增设【博士生论坛】【企业创业先锋论坛】等多元日程。
-
历届参会规模新高:1500+ 青年学者、一线工程师齐聚
-
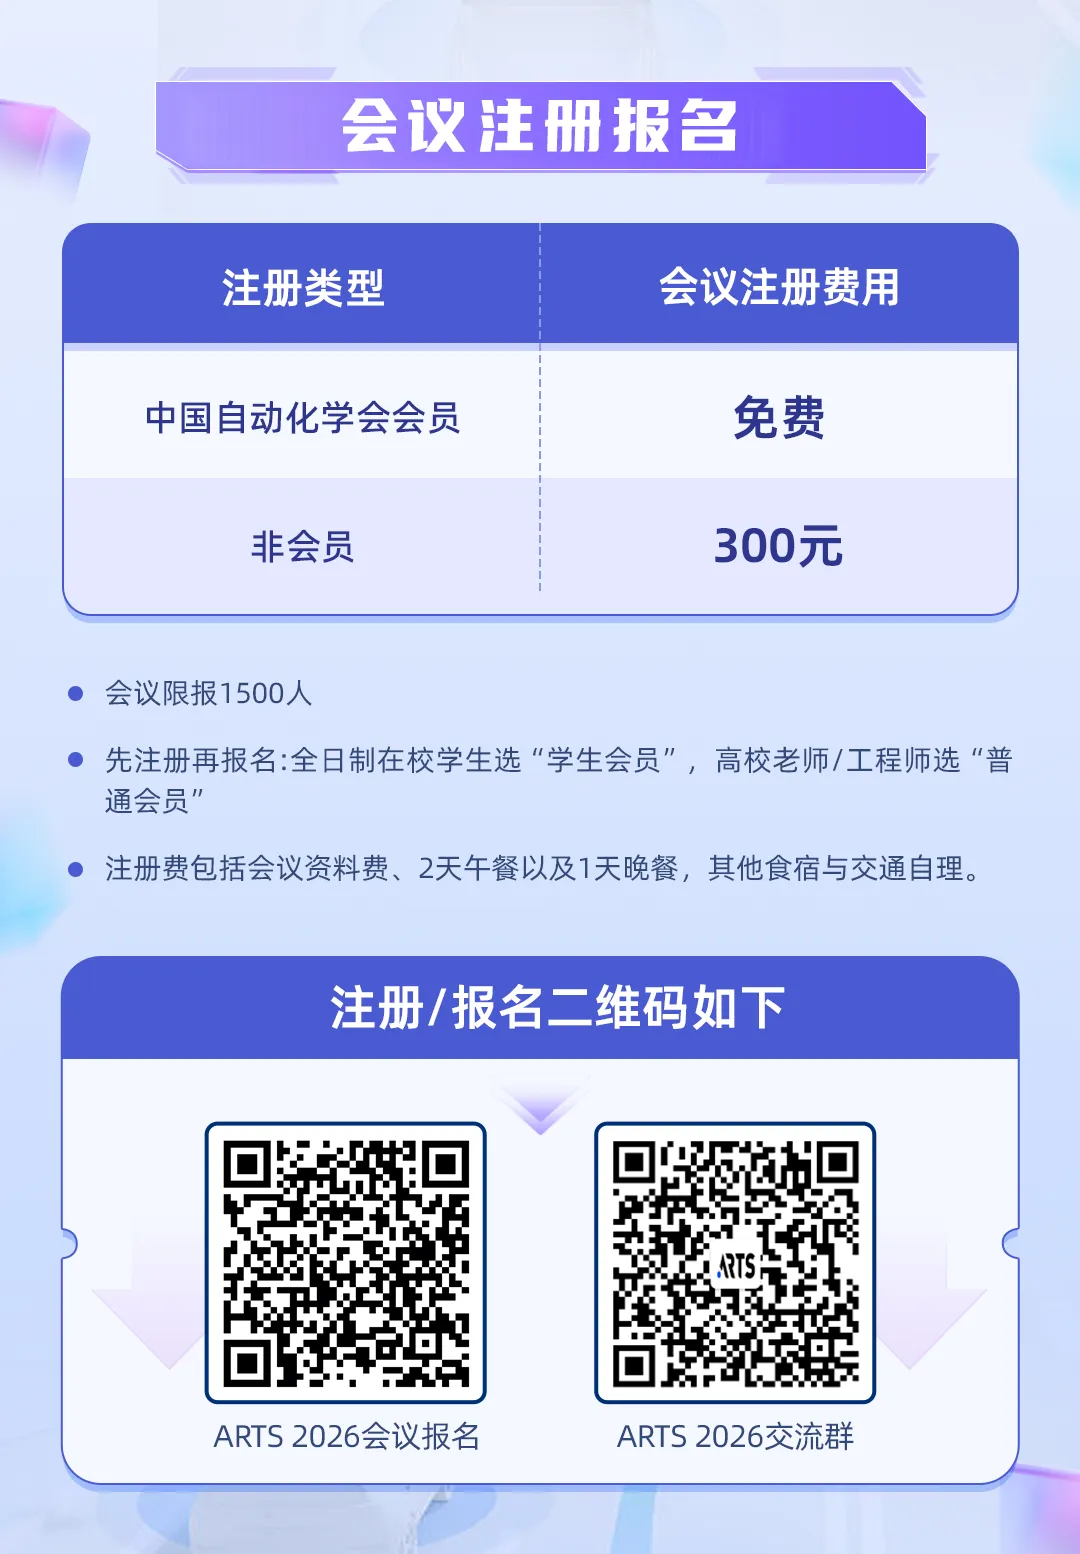
历届参会成本最低:中国自动化学会会员免费参会,学生参会最低仅需 50 元
本届ARTS研讨会内容丰富,大咖云集。为了方便大家快速锁定感兴趣的领域,我们将分期为大家详细介绍各个分论坛的精彩内容。
目前会议注册通道已经开放。
名额有限,抓紧报名!
注:报告嘉宾按姓名首字母排序,排名不分先后
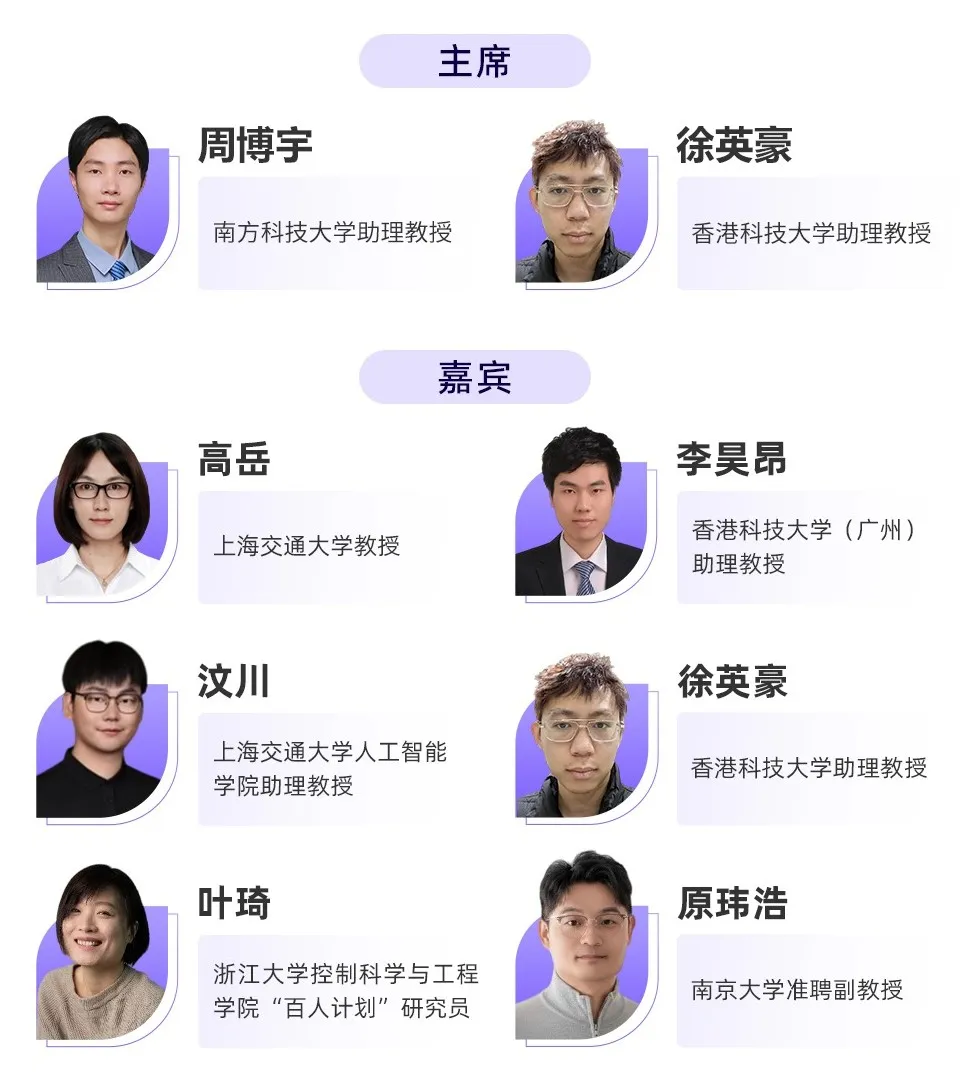
嘉宾简介&报告详情
注:报告嘉宾按姓名首字母排序,排名不分先后
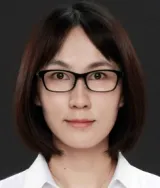
高岳
个人简介:
高岳,上海交通大学/上海创智学院教授、博士生导师,美国康奈尔大学博士,国家级青年人才、上海市东方英才学者。主要研究方向为具身智能与人形机器人,聚焦人形机器人全身运动控制、行为基础模型、视觉-语言-动作模型,以及足式机器人在复杂与极端环境下的自主适应与智能交互。围绕机器人从运动控制、技能学习到高层感知与决策的完整技术链条开展研究,研制了足式越野机器人、滑雪机器人、月球飞跃器、乒乓球机器人等代表性系统。近年来在 NeurIPS、ICLR、AAAI等人工智能与机器人领域重要会议及期刊发表论文70余篇,主持国家重点研发计划课题、国家自然科学基金重大研究计划课题及面上项目等。曾获世界人工智能大会“卓越人工智能引领者”奖、全国高校教师教学创新大赛一等奖等奖项。
报告主题:
具身小脑:构建兼具泛化性与时空一致性的行为底座
报告摘要:
具身智能不仅需要理解任务的“大脑”,还需要将任务意图稳定转化为全身动作的“小脑”。本报告提出分层行为生成框架:在共享隐空间中沉淀行走、平衡、姿态协调与运动恢复等通用先验,形成可冻结、可迁移的行为底座;通过轻量级任务适配器和高层规划器注入物体、接触与目标信息,在保留通用能力的同时快速形成专一技能。为保证时空一致性,关键帧、轨迹和接触条件统一表示为带时间约束的身体—环境关系,结合长短期预测和关系—物理能量筛选生成可执行动作,并依据实时状态闭环重规划,为具身大脑的通用性和泛化性奠定行为基础。
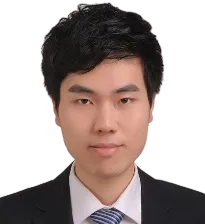
李昊昂
个人简介:
李昊昂,香港科技大学(广州)助理教授(副研究员),博士生导师,国家级青年人才。此前于德国慕尼黑工业大学担任博士后研究员,于香港中文大学获得博士学位,博士期间于瑞士苏黎世联邦理工学院进行学术访问,于武汉大学获得硕士和学士学位。在计算机视觉和机器人行业顶级期刊和会议(例如TPAMI、TRO、CVPR、ICLR等)发表50余篇论文,工作曾获得AAAI 2026杰出论文奖,入围 CVPR 2025最佳论文候选。目前负责国家科技重大专项子课题,主持国家自然科学基金项目、广东省自然科学基金项目等。担任TRO、ICRA、IROS、AAAI编委,以及IROS 2025组委会成员等。主要研究方向为具身智能机器人、三维计算机视觉。
报告主题:
注入空间信息,强化因果推理:复杂场景下的具身操作
报告摘要:
视觉语言操作是具身机器人领域的核心研究方向。现有研究大多基于理想实验环境开展,普遍忽略真实场景中的各类复杂干扰因素。针对该问题,本报告以融入空间信息、强化因果推理为核心优化思路,系统介绍了团队的最新研究成果。研究围绕视觉、语言、动作三大核心要素开展针对性优化,提出一系列精准高效的算法方案,有效解决注意力定位不准、复杂指令理解困难、动作预测延迟等关键难题。同时,本报告讲简要阐述课题组在动态交互生成技术的研究进展,可为具身智能的后续研究提供数据基础。
个人简介:
报告主题:
报告摘要:
具身智能系统的规模化发展,面临数据采集成本高、场景覆盖不足以及采集与训练衔接不畅等问题。本报告围绕“规模化具身数据采集与后训练系统”主题,介绍RoboPocket系统的设计思路与实现框架。系统以消费级智能手机为便携式采集终端,融合机器人同构夹爪、视觉惯性定位、运动学校验和多设备时空同步,实现真实环境下的操作数据采集;通过远程策略推理和增强现实视觉前瞻,将策略意图反馈给操作者,支持失效状态识别与纠正样本采集;结合数据实时上传、离线与在线样本协同、异步参数更新和模型分发,形成采集、训练、评估、迭代的一体化闭环。报告将讨论其对降低操作门槛、支撑多场景协同和促进具身策略持续后训练的意义。
个人简介:
报告主题:
报告摘要:
Robots need three capabilities to operate in the physical world: spatial understanding, predictive dynamics, and real-time action. In this talk, I will present three pieces of the LingBot embodied intelligence stack: LingBot-Map, LingBot-VA, and LingBot-VA2. LingBot-Map addresses streaming 3D reconstruction, building compact and temporally consistent spatial memory from continuous visual input. LingBot-VA then moves from perception to control by introducing causal video-action modeling, where a robot policy predicts future visual states together with the actions that cause them. Building on this direction, LingBot-VA2 develops a native video-action foundation model designed for embodied control, with semantic visual-action tokenization, causal pretraining, sparse MoE scaling, human-robot co-training, and asynchronous closed-loop inference. Together, these systems illustrate a path from reconstructing the world, to predicting how it changes, to acting in it efficiently and robustly. I will discuss the key technical ideas, real-world demonstrations, and open challenges toward scalable embodied foundation models.
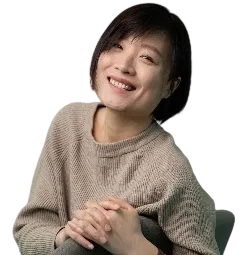
个人简介:
报告主题:
报告摘要:
近些年人形机器人呈现蓬勃发展趋势,相对现有工业制造领域的固定产线,其发展将给生产和管理等环节带来更大的灵活性。赋予人形机器人智能的能力是目前机器人领域最前沿和火热的方向,而实现类人机器灵巧手操作是其中最具挑战的问题之一。不同于简单的夹爪和吸盘操作,类人多指灵巧手面临极高的自由度和极为复杂的手物操作空间变化,造成人形机器人操作技能学习的困难。本报告将从基于人类操作先验数据驱动下操作手势生成,到灵巧手操作技能学习等方面探索高效地利用人类操作经验解决上述挑战,实现类人灵巧操作的技能建立和迁移。
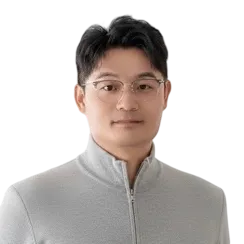
个人简介:
报告主题:
报告摘要:
深度学习和大模型的发展,给机器人动作生成带来了新的思路。通过融合视觉、语言、动作等模态的信息,可以构建多模态模型,从而直接基于人类指令让机器人去做相应的动作,提升了机器人的智能易控程度。而基于大规模数据的多模态模型训练,可以同时使机器人获得通用泛化能力,胜任多种多样不同的任务。 另一方面,尽管目前模型对语言、视觉、声音等模态获得了非凡的处理能力,但对人类所掌握的更基础的物理世界却仍旧认知有限,这一定程度上源于这些模态离物理世界较远。人类在感知物理世界的时候,往往使用的是另一种感官——触觉,这一模态的信息赋予人类能够认知、交互物理世界的能力。因此,利用触觉模态,可以显著增强模型对物理世界的认知能力,提升模型对物理世界的操作交互能力。
(最终排序以会议会刊内容为准)
-
中国自动化学会会员注册链接: https://www.caa.org.cn/Content/10.html -
ARTS 2026会议注册链接: https://www.cacpaper.com/register/172/user/preRegist
了解线下会议详情
请扫码加入【ARTS 2026 交流群】
联系电话:18514821626(同微信)
联系邮箱:liupengxiao@shenlanxueyuan.com
联系邮箱:conference@caa.org.cn
ARTS 2026 |第四届自主机器人研讨会「学术吐槽大会」席位开放!